第 4 章 弾力性に優れたアーキテクチャの設計(26%)
スケーラブルで疎結合なアーキテクチャ
この章で学ぶこと
- API の作成と管理(API Gateway、REST API)
- キャッシュ戦略/イベント駆動アーキテクチャ
- 水平スケーリングと垂直スケーリング
- ロードバランシング/キューイングとメッセージング
- サーバーレスの技術とパターン(Fargate、Lambda)
この章に出てくる用語
- Auto Scaling グループ(ASG)
- 同じ役割の EC2 をひとまとまりとして扱い、台数を自動で増減させる仕組み。 最小・希望・最大の 3 つの数を決めておき、条件に応じて希望の数を動かす。壊れたインスタンスを捨てて新しく立てるのも ASG の仕事なので、台数が 1 台でも ASG に入れておく意味がある。
- 可視性タイムアウト(Visibility Timeout)
- 受け取ったメッセージを、他の処理から一時的に見えなくする時間。 処理が終わって削除すればそのまま消えるが、時間内に削除されなければ再びキューに現れ、別の処理が取れるようになる。処理に時間がかかるのにこれが短いと、同じメッセージが二重に処理される。「重複して処理されてしまう」という設問はここが原因。
2 つの処理が直接呼び合っていると、呼ばれる側が落ちたら呼ぶ側も止まるし、呼ばれる側が遅いと呼ぶ側も遅くなるし、片方だけ増やすこともできない。間に何かを挟むと、この 3 つが同時に解ける。
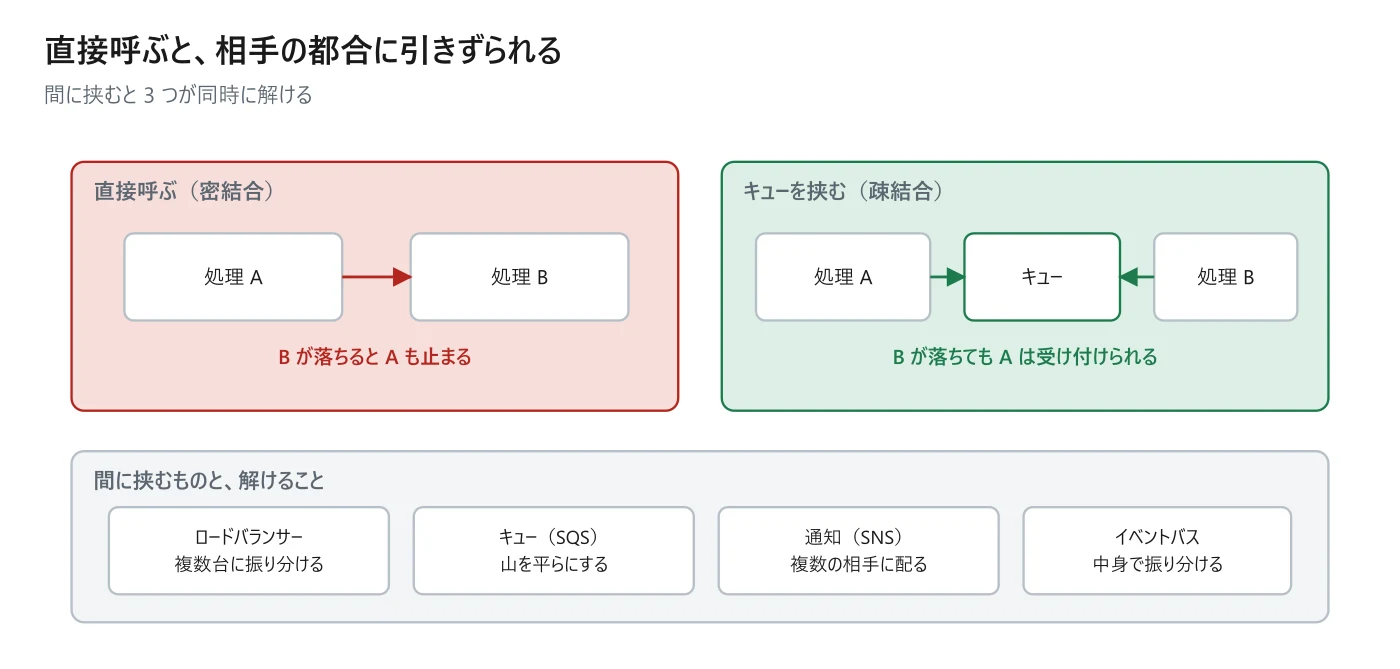
| 挟むもの | 解けること | 代表例 |
|---|---|---|
| ロードバランサー | 同じ役割の複数台に振り分ける | ALB/NLB |
| キュー | 相手が落ちていても受け付けられる。処理の速さを切り離す | Amazon SQS |
| 通知(Pub/Sub) | 1 つの出来事を複数の相手に配る | Amazon SNS |
| イベントバス | 出来事の内容で行き先を振り分ける | Amazon EventBridge |
| ワークフロー | 手順と失敗時の扱いを外に出す | AWS Step Functions |
試験では
「スケーラブル(拡張できる)」と「疎結合」はセットで問われる。問題文に「ピーク時に処理が詰まる」「片方だけ増やしたい」「相手のメンテナンス中もリクエストを受けたい」と書かれていたら、間に何かを挟む選択肢を探す。
Elastic Load Balancing(ELB)には 3 つの型がある。どの層で判断するかが違う。
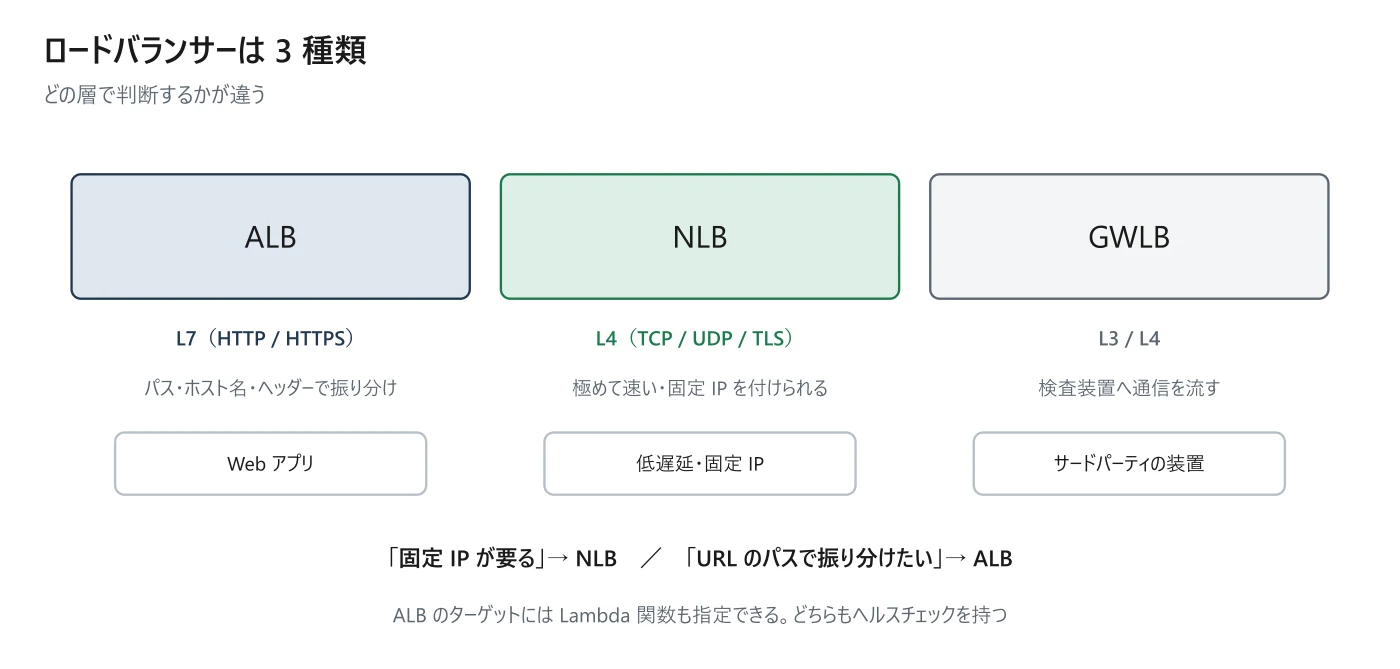
| ALB | NLB | GWLB | |
|---|---|---|---|
| 層 | L7(HTTP / HTTPS) | L4(TCP / UDP / TLS) | L3 / L4 |
| できる判断 | URL のパス・ホスト名・ヘッダーで振り分け | ポートで振り分けるだけ | 通信を検査装置へ流す |
| 速さ | ふつう | 極めて速い・大量 | ― |
| IP | 可変(DNS 名で使う) | AZ ごとに固定 IP/Elastic IP を付けられる | ― |
| 向く用途 | Web アプリ・マイクロサービス | 低遅延・固定 IP が要る・TCP そのもの | サードパーティの仮想アプライアンス |
試験では
「固定 IP が要る」と書かれていたら NLB。 ALB の IP は変わる。「URL のパスで振り分けたい」なら ALB。 NLB は中身を見ない。この 2 つの取り違えが最も多い。
補足
ALB のターゲットには EC2 だけでなく Lambda 関数も指定できる。「既存の ALB の後ろに、一部だけサーバーレスを足したい」という設問で出る。また、どちらのロードバランサーもヘルスチェックを持ち、応答しないターゲットには振らなくなる。
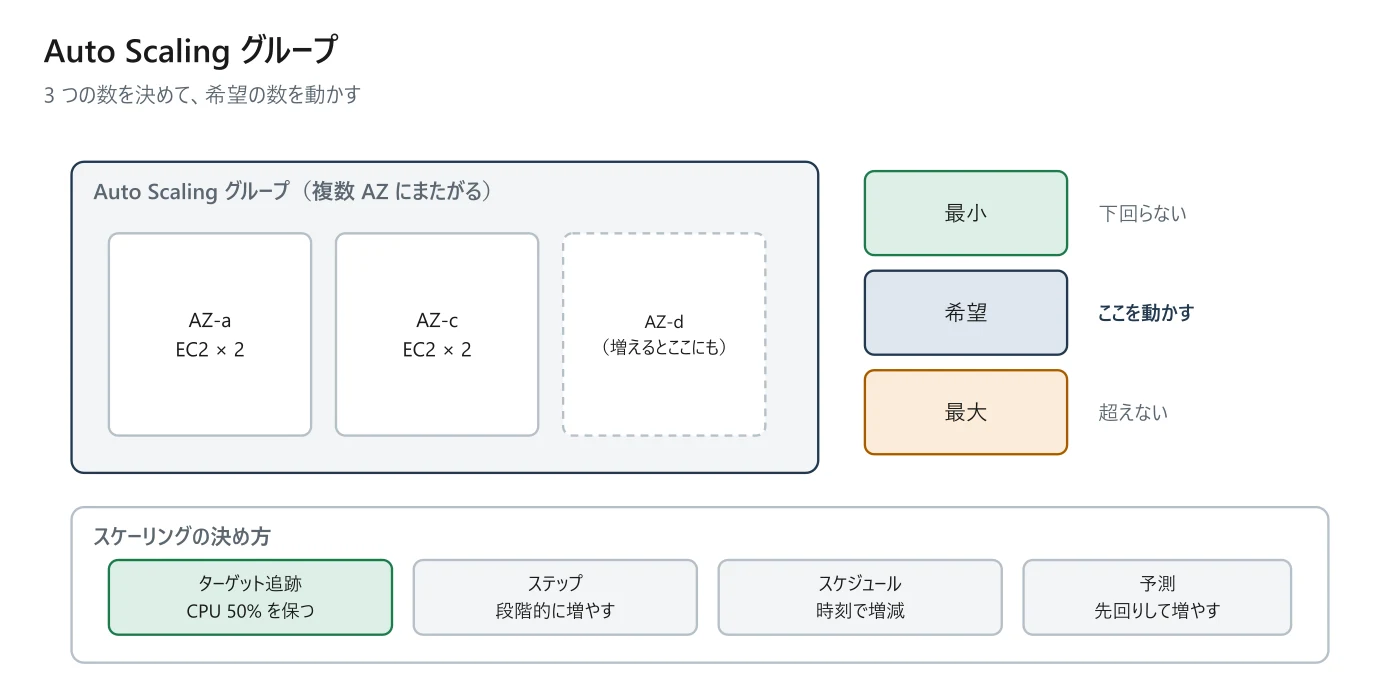
| スケーリングの方式 | どう決めるか | 向く場面 |
|---|---|---|
| ターゲット追跡 | 指標を目標値に保つ(CPU 50% を維持) | ふつうはこれ。設定が最も簡単 |
| ステップ | しきい値ごとに増やす数を変える | 急な山に段階的に備えたい |
| シンプル | しきい値を超えたら増やす | 古い方式。新規では使わない |
| スケジュール | 時刻で増減させる | 毎週月曜の朝に増える、など読める山 |
| 予測(Predictive) | 過去の傾向から先回りして増やす | 立ち上がりに時間がかかるワークロード |
試験では
ASG のヘルスチェックには EC2 のものと ELB のものがある。既定は EC2 のチェックだけなので、OS は生きているがアプリが落ちている状態を検出できない。「アプリが応答しないのに入れ替わらない」という設問は、ELB のヘルスチェックを有効にするのが答え。
補足
ASG は複数の AZ にまたがって作るのが基本。1 つの AZ だけで組むと、その AZ が落ちたときに全滅する。また、起動に時間がかかるアプリにはウォームプール(準備済みの待機インスタンス)がある。
疎結合の中心にある 3 つだ。配る先が 1 つか多数か、中身で振り分けるかで分かれる。
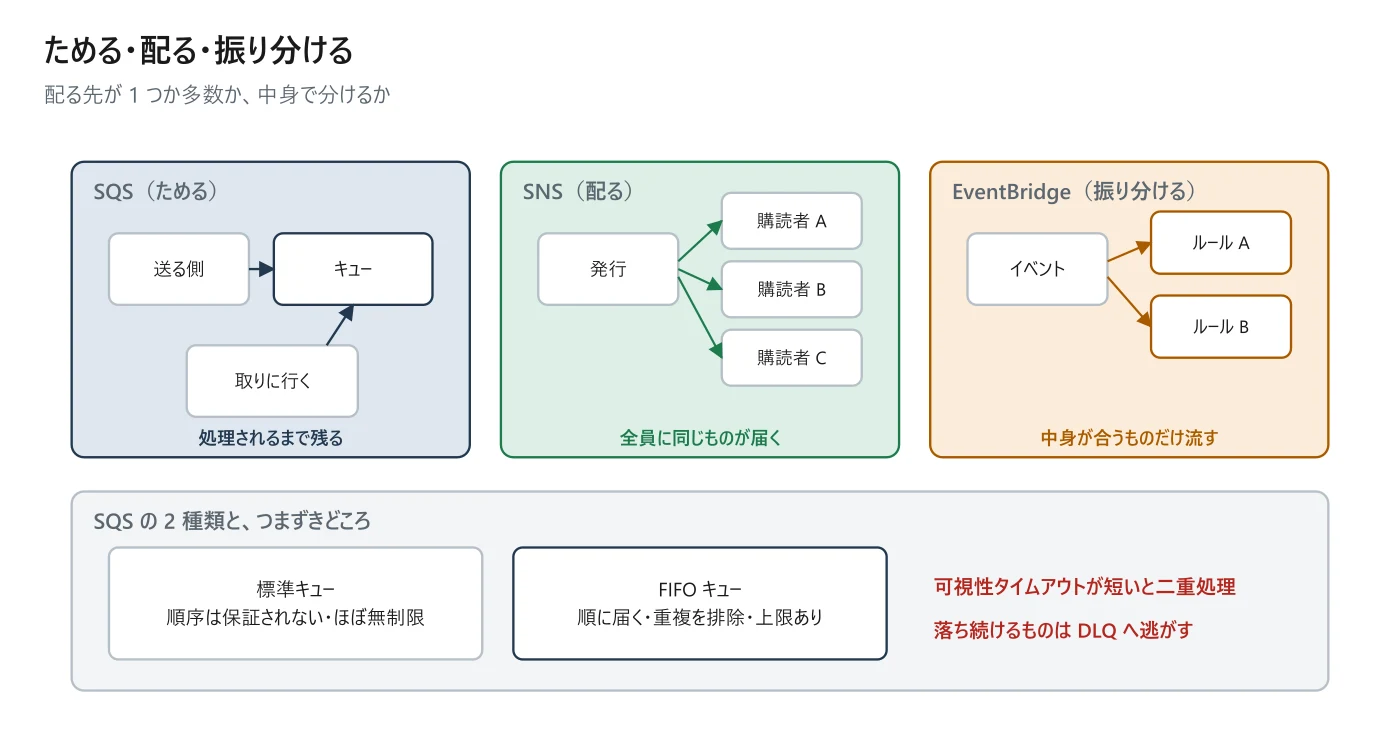
| Amazon SQS | Amazon SNS | Amazon EventBridge | |
|---|---|---|---|
| 形 | キュー(ためる) | 通知(配る) | イベントバス(振り分ける) |
| 受け取る側 | 取りに行く(ポーリング) | 押し込まれる(プッシュ) | ルールに合う先へ押し込む |
| 相手の数 | 1 つの処理が 1 件を取る | 購読者すべてに同じものを配る | ルール次第 |
| 残るか | 処理されるまで残る | 配信時にいなければ届かない | ― |
| 向く場面 | 処理の山を平らにする | 1 つの出来事を複数系統へ | SaaS や AWS のイベントで分岐 |
SQS には 2 種類あり、ここも問われる。
| 標準キュー | FIFO キュー | |
|---|---|---|
| 順序 | 保証されない | 送った順に届く |
| 重複 | まれに 2 回届くことがある | 重複を排除する |
| スループット | 事実上無制限 | 制限あり(バッチ処理で緩和) |
| 使いどころ | 順序が関係ない処理 | 決済や在庫など順序が意味を持つ処理 |
補足
既存のアプリが ActiveMQ や RabbitMQ(AMQP・MQTT などの標準プロトコル)を使っている場合は、Amazon MQ が答えになる。SQS や SNS は AWS 独自の API なので、アプリを書き換えずに移したいという要件では選べない。逆に、新規に作るなら SQS / SNS のほうが運用が軽い。
試験では
何度やっても落ちるメッセージは、デッドレターキュー(DLQ)へ逃がす。これを置かないと、壊れた 1 件がキューを塞ぎ続ける。「特定のメッセージで処理が止まる」はこの型。
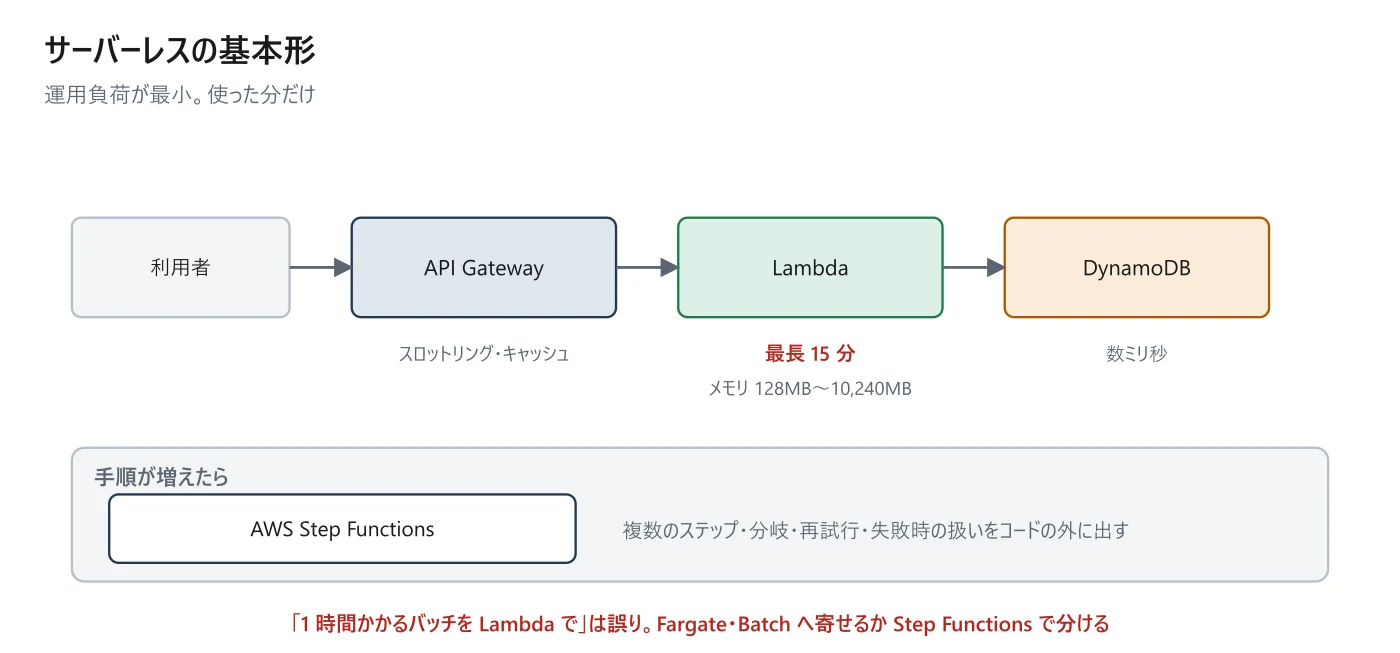
サーバーを立てずに処理を動かす形は、SAA でとても強い答えになる。運用負荷が最小で、使った分だけ課金されるからだ。
| 役割 | サービス | 押さえる数字・性質 |
|---|---|---|
| 入口 | Amazon API Gateway | スロットリング・キャッシュ・認証を持てる |
| 処理 | AWS Lambda | 最長 15 分。メモリは 128MB〜10,240MB。CPU はメモリに比例 |
| データ | Amazon DynamoDB | 数ミリ秒。サーバーレスと相性がよい |
| 手順の管理 | AWS Step Functions | 複数のステップと失敗時の扱いを外に出す |
| コンテナ | AWS Fargate | コンテナをサーバー無しで動かす |
試験では
Lambda は 15 分で必ず止まる。「1 時間かかるバッチ処理を Lambda で」は誤り。その場合は Fargate・Batch・EC2 へ寄せるか、Step Functions で分割する。この境目は頻出。
補足
Lambda のメモリを増やすと CPU も比例して増える。「処理が遅いのでメモリを増やしたら速くなった」のはこのため。結果として実行時間が短くなり、合計の料金はむしろ下がることがある。
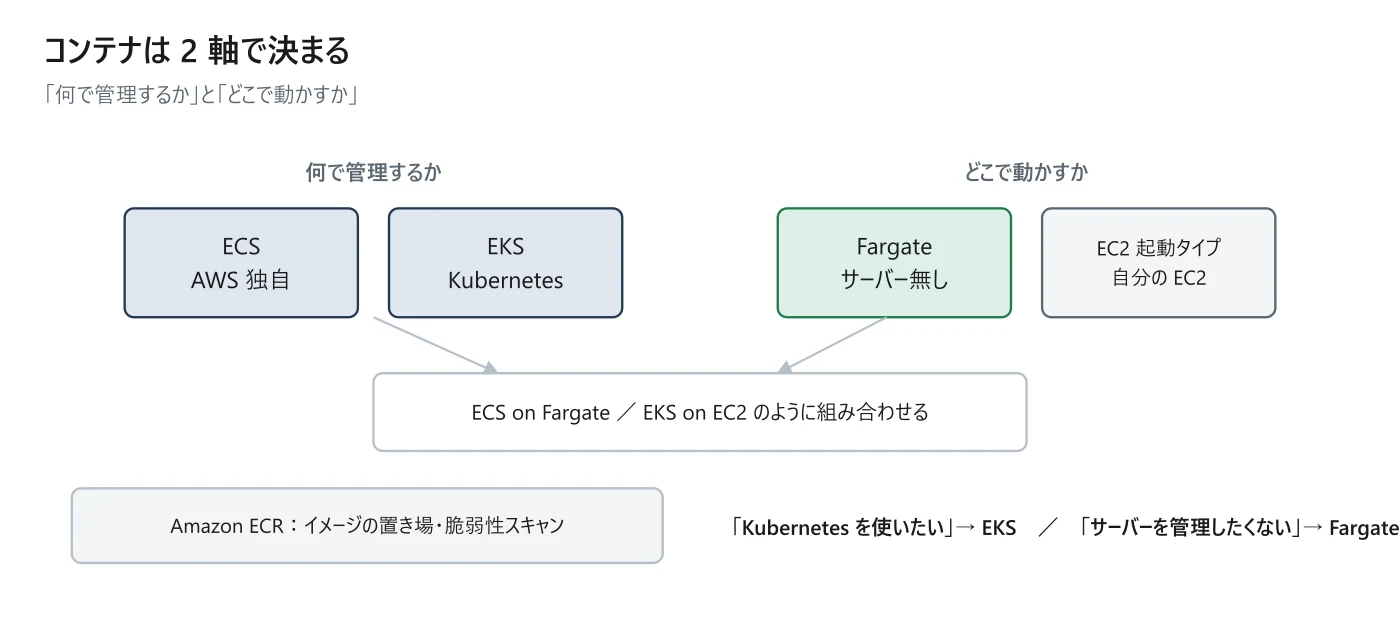
コンテナのサービスは名前が多いが、「何で管理するか」と「どこで動かすか」の 2 軸に分けると整理できる。
| 何か | 選ぶ理由 | |
|---|---|---|
| Amazon ECS | AWS 独自のコンテナ管理 | シンプル。AWS だけで完結する |
| Amazon EKS | マネージドな Kubernetes | Kubernetes の資産や知識を使いたい |
| AWS Fargate | サーバーを持たない実行基盤 | EC2 の管理をしたくない |
| EC2 起動タイプ | 自分の EC2 で動かす | インスタンスを細かく制御したい・安くしたい |
| Amazon ECR | コンテナイメージの置き場 | イメージの保管と脆弱性スキャン |
試験では
ECS と EKS は「管理のしかた」、Fargate と EC2 は「どこで動くか」。ECS と Fargate は対立する選択肢ではない(ECS on Fargate という組み合わせがある)。「Kubernetes を使いたい」なら EKS、「サーバーを管理したくない」なら Fargate。
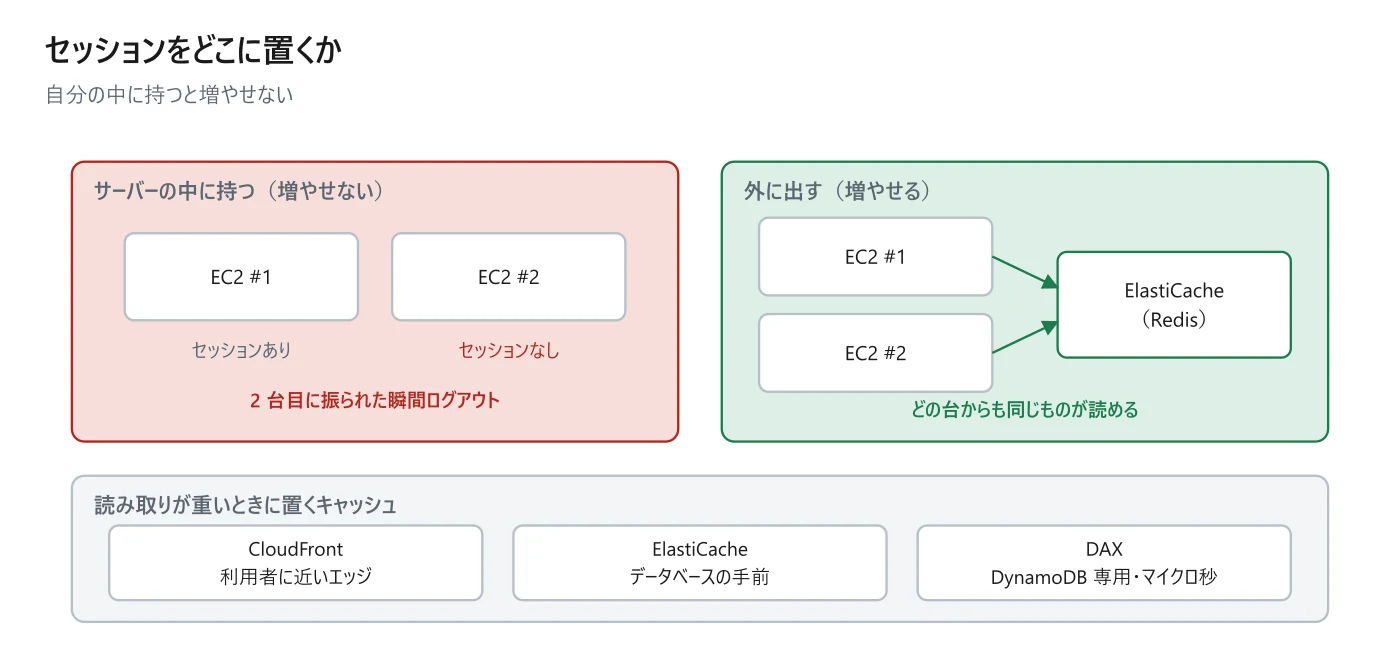
増やせない設計のもう 1 つの理由が状態だ。ログイン情報をサーバーのメモリに持っていると、2 台目に振り分けられた瞬間にログアウトしてしまう。
| やり方 | どうなるか |
|---|---|
| サーバーのメモリに持つ | 増やせない。 1 台落ちるとそのユーザーのセッションが消える |
| ロードバランサーのスティッキーセッション | 同じ人を同じ台へ送る。その台が落ちると消える。増減にも弱い |
| ElastiCache(Redis)に置く | どの台からも読める。 速い。定番の答え |
| DynamoDB に置く | どの台からも読める。耐久性が高い |
同じ考え方は読み取りの負荷にも効く。よく読まれるデータをキャッシュに置けば、後ろの負荷が減る。置き場所は 3 つある。
- CloudFront ―― 利用者に近いエッジで静的コンテンツを返す(第 9 章)
- ElastiCache ―― データベースの手前で、よく読まれる結果を保持する(第 8 章)
- DynamoDB Accelerator(DAX) ―― DynamoDB 専用のキャッシュ。マイクロ秒まで速くなる
試験では
「読み取りが重い」ならキャッシュかリードレプリカ。キャッシュは同じものを何度も読むとき、リードレプリカは読み取りそのものを分散したいときに効く。両方を足す構成が正解になることもある。
シナリオ演習
注文の受付 API が、繁忙期にバックエンドの在庫処理の遅さに引きずられてタイムアウトするようになった。アプリの改修は最小限にしたい。
補足
答え:受付と在庫処理の間に SQS を置き、受付は書き込んだ時点で応答を返す。在庫処理はキューから自分のペースで取る。
在庫処理を速くする案(インスタンスを大きくする)は、繁忙期の山に対して根本解決にならない。キューを挟むと、受付側は相手の速さに縛られなくなる。
シナリオ演習
SQS のワーカーが、同じメッセージを 2 回処理してしまうことがある。処理には 3 分かかる。
補足
答え:可視性タイムアウトを処理時間より十分長く(たとえば 5 分以上に)設定する。
既定の 30 秒のままだと、処理中に再びキューへ戻って別のワーカーが取ってしまう。FIFO キューに変える案は順序の話で、この原因には効かない。
この章のまとめ
- 間にキューを挟むと解けること
- URL のパスで振り分けられるロードバランサー
- 固定 IP を付けられるロードバランサー
- ALB のターゲットにできる EC2 以外のもの
- ASG が持つ 3 つの数
- ふつう選ぶスケーリング方式
この章の根拠
最終確認 2026-10-04 / 対応バージョン DEA 2026-05-04 改訂版