第 5 章 弾力性に優れたアーキテクチャの設計(26%)
壊れても続く設計
この章で学ぶこと
- AWS のグローバルインフラストラクチャ(AZ、リージョン、Route 53)
- 災害対策(DR)の戦略(バックアップと復元、パイロットライト、ウォームスタンバイ、アクティブ/アクティブのフェイルオーバー、RPO、RTO)
- フェイルオーバーの戦略/分散設計のパターン
- イミュータブルインフラストラクチャ
- プロキシの概念(RDS Proxy)
この章に出てくる用語
- Amazon Route 53
- AWS の DNS サービス。 名前(example.com)を IP やエンドポイントに対応づける。リージョンに属さないグローバルなサービスで、単に名前を引くだけでなく、ヘルスチェックの結果で行き先を変えることができる。この「行き先を変える」仕組みが、リージョンをまたぐフェイルオーバーの土台になる。
- RPO と RTO
- RPO(Recovery Point Objective)は「どれだけのデータ消失を許せるか」。 1 時間なら、障害直前 1 時間ぶんの更新が消えてもよい、という意味。RTO(Recovery Time Objective)は「どれだけ止まっていてよいか」。 4 時間なら、4 時間以内に復旧すればよい。どちらも「短くするほど高くなる」ので、要件に書かれた数字を読んでちょうどの戦略を選ぶ。
- Amazon RDS Proxy
- アプリとデータベースの間に入って、接続をまとめて使い回す仕組み。 Lambda のように短い処理が大量に立ち上がると、そのたびに DB へ接続して接続数が尽きる。プロキシが接続を保持して配ることで、これを防ぐ。フェイルオーバー時の切り替えも速くなる。
- イミュータブルインフラストラクチャ
- 動いているサーバーに手を入れず、作り直して置き換える考え方。 パッチを当てるのではなく、パッチ済みの AMI から新しいインスタンスを立て、古いものを捨てる。台ごとの差異(構成ドリフト)が生まれないので、「あの 1 台だけ動かない」が起きなくなる。ASG と起動テンプレートがこれを支える。
- AWS CloudFormation
- 作りたい構成をテンプレート(YAML / JSON)に書いて、まとめて作る仕組み。 作ったものは「スタック」としてひとまとまりで管理され、消すときもスタックごと消せる。変更セット(Change Set)を使うと、適用前に何が変わるかを確認できる。同じテンプレートから、開発・検証・本番を同じ形で作れるのが利点。
どちらも「止まらない」ことに見えるが、設問では使い分けられている。
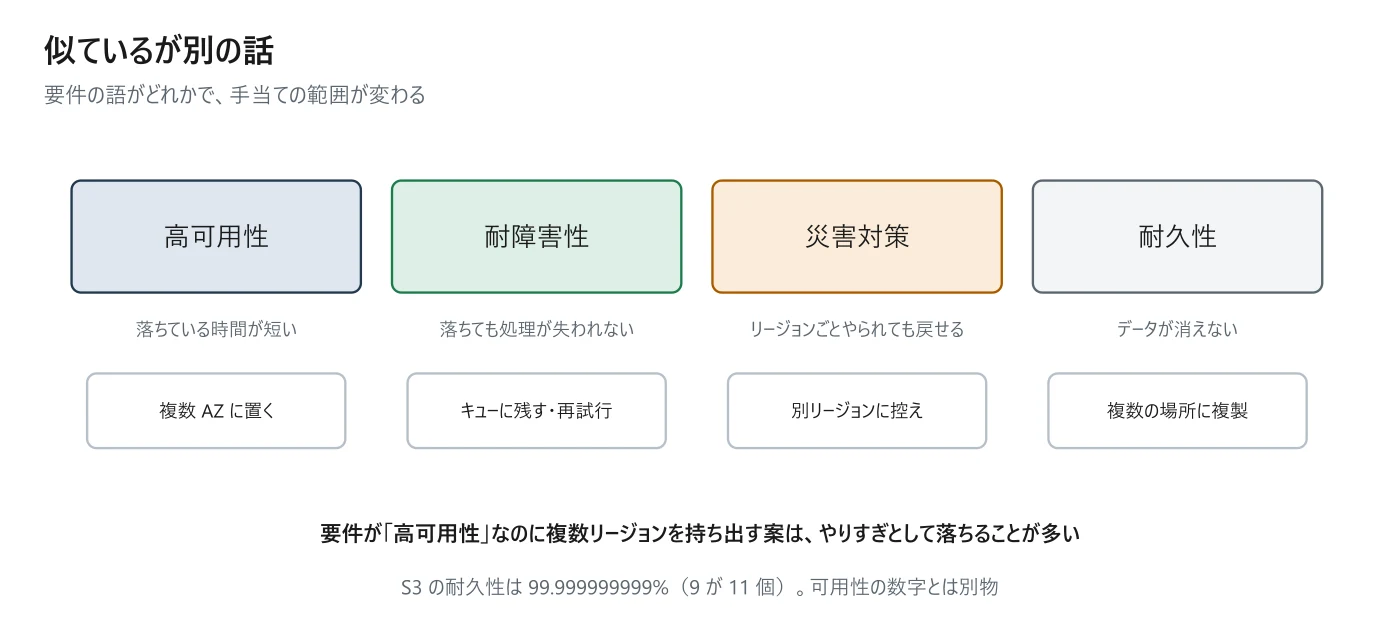
| 何を言っているか | 典型的な手当て | |
|---|---|---|
| 高可用性(HA) | 落ちている時間が短い | 複数 AZ に置く。壊れたら自動で入れ替える |
| 耐障害性(FT) | 落ちても処理が失われない | キューに残す。再試行する。冗長に持つ |
| 災害対策(DR) | リージョンごとやられても戻せる | 別リージョンに控えを持つ。4 つの戦略から選ぶ |
| 耐久性(Durability) | データが消えない | 複数の場所に複製する(S3 は 11 個の 9) |
試験では
「高可用性」と書かれていたら、まず複数 AZ になっているかを見る。単一 AZ のままで「冗長化した」という選択肢は落ちる。逆に、要件が可用性なのに複数リージョンを持ち出す選択肢はやりすぎ(高い)として落ちることが多い。
1 つ壊れたら全部止まる場所を単一障害点(SPOF)と呼ぶ。設問は「この構成の単一障害点はどれか」「どう直すか」を聞いてくる。
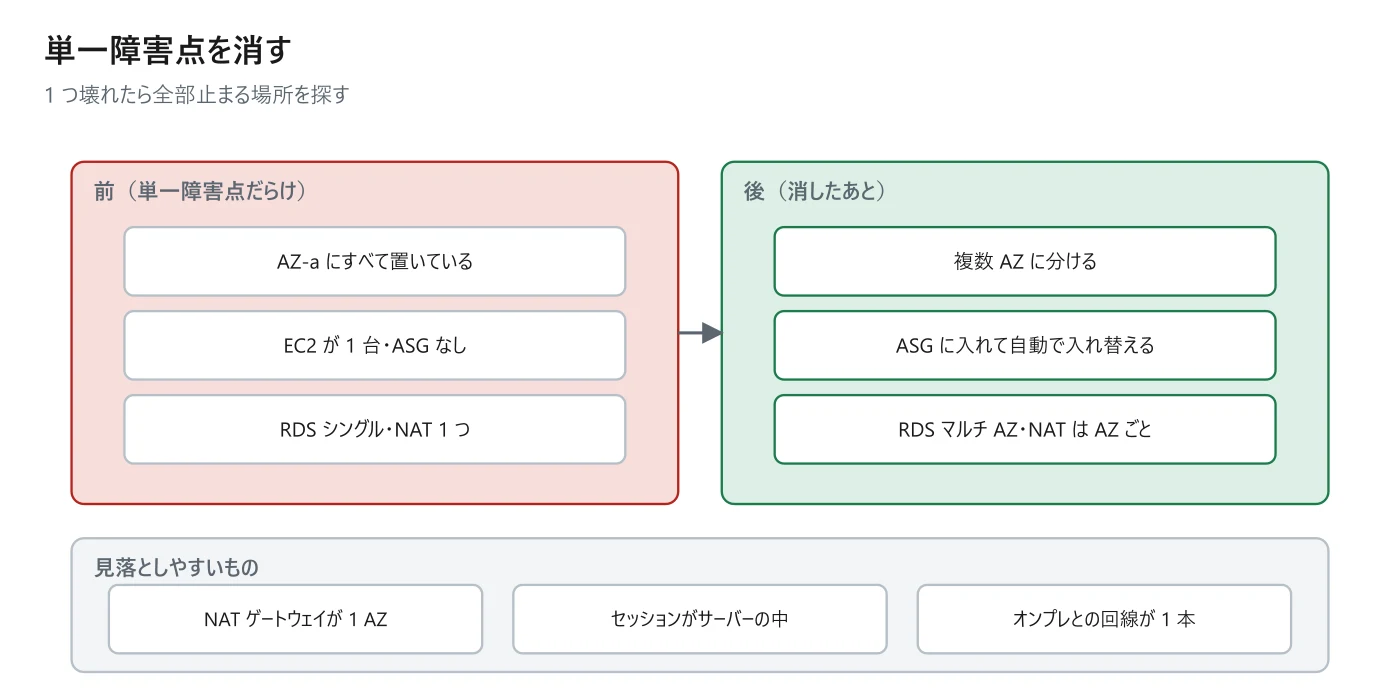
| よくある単一障害点 | 直し方 |
|---|---|
| EC2 が 1 台だけ | ASG に入れて複数 AZ に分ける |
| NAT ゲートウェイが 1 つ(1 AZ) | AZ ごとに NAT を置く |
| RDS がシングル構成 | マルチ AZ 配置にする |
| セッションがサーバーの中 | ElastiCache や DynamoDB へ出す |
| 1 つの AZ にすべて置いている | 複数 AZ へ分ける |
| オンプレとの回線が 1 本 | Direct Connect を 2 本/VPN をバックアップに |
補足
NAT ゲートウェイは AZ 単位のサービスだ。AZ-a に 1 つだけ置いて AZ-c のサブネットからも使っていると、AZ-a が落ちたときに AZ-c のサーバーも外へ出られなくなる。さらに AZ をまたぐ通信なので転送料もかかっている(第 14 章)。
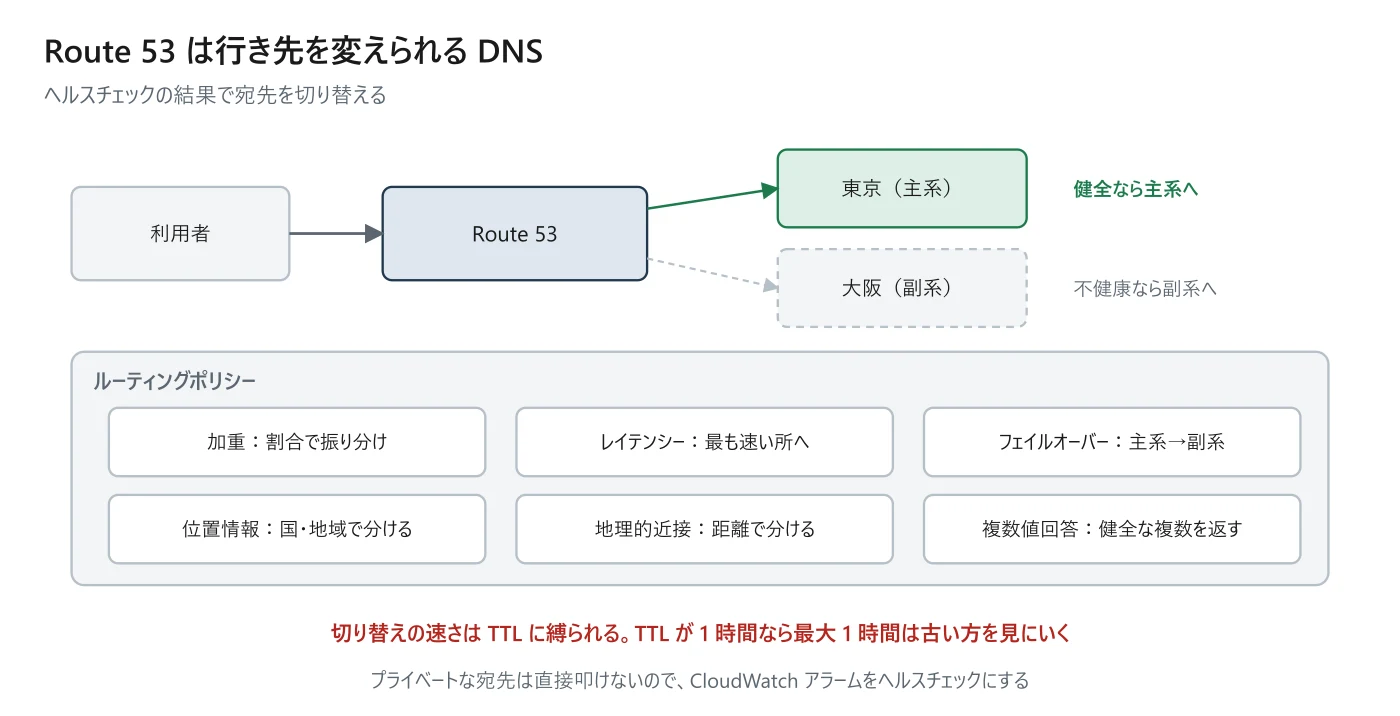
| ポリシー | どう決めるか | 使う場面 |
|---|---|---|
| シンプル | 1 つの宛先を返す | ふつうの名前解決 |
| 加重(Weighted) | 割合で振り分ける | 新しい版に 10% だけ流す(カナリア) |
| レイテンシー | 最も速いリージョンへ | 世界中の利用者に近い方を使わせたい |
| フェイルオーバー | 主系が不健康なら副系へ | リージョン障害時の切り替え |
| 位置情報(Geolocation) | 利用者の国・地域で分ける | 国ごとに内容や法令が違う |
| 地理的近接(Geoproximity) | 距離で分け、偏りも付けられる | 拠点ごとに寄せる |
| 複数値回答 | 健全な複数の IP を返す | 簡易な分散。ロードバランサーの代わりではない |
試験では
切り替えの速さは TTL に縛られる。DNS の応答はクライアントにキャッシュされるので、TTL が 1 時間なら切り替えても最大 1 時間は古い方を見にいく。「フェイルオーバーが遅い」という設問では TTL を短くするのが答え。
補足
ヘルスチェックには 3 種類ある。エンドポイントを直接叩くもの、複数のヘルスチェックを束ねて判断するもの(計算型)、CloudWatch アラームの状態を見るものだ。プライベートな宛先は直接叩けないので、CloudWatch アラーム経由にする。
リージョンごと使えなくなったときにどう戻すか。選び方は RPO と RTO で決まる。
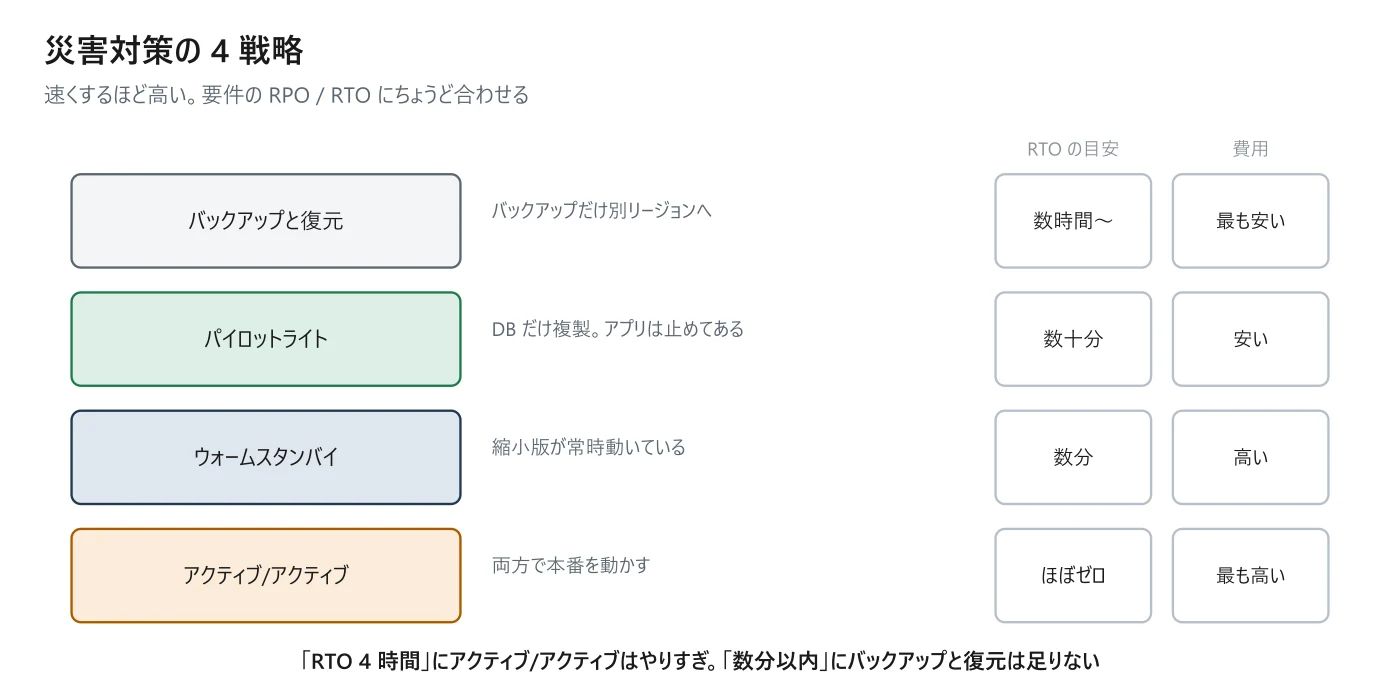
| 戦略 | ふだんの状態 | RTO の目安 | 費用 |
|---|---|---|---|
| バックアップと復元 | 何も動かしていない(バックアップだけ別リージョンへ) | 数時間〜 | 最も安い |
| パイロットライト | 最小限(DB だけ複製)。アプリは止めてある | 数十分 | 安い |
| ウォームスタンバイ | 小さく動かしている。縮小版が常時稼働 | 数分 | 高い |
| アクティブ/アクティブ | 両方で本番を動かしている | ほぼゼロ | 最も高い |
試験では
要件の数字と戦略を突き合わせる。「RTO 4 時間・RPO 1 時間」ならバックアップと復元かパイロットライトで足りる。ここでアクティブ/アクティブを選ぶのはやりすぎで、コストの観点から落ちる。逆に「数分以内」にバックアップと復元を選ぶと足りない。
RDS には似て非なる 2 つの仕組みがあり、目的がまったく違う。取り違えが頻出する。
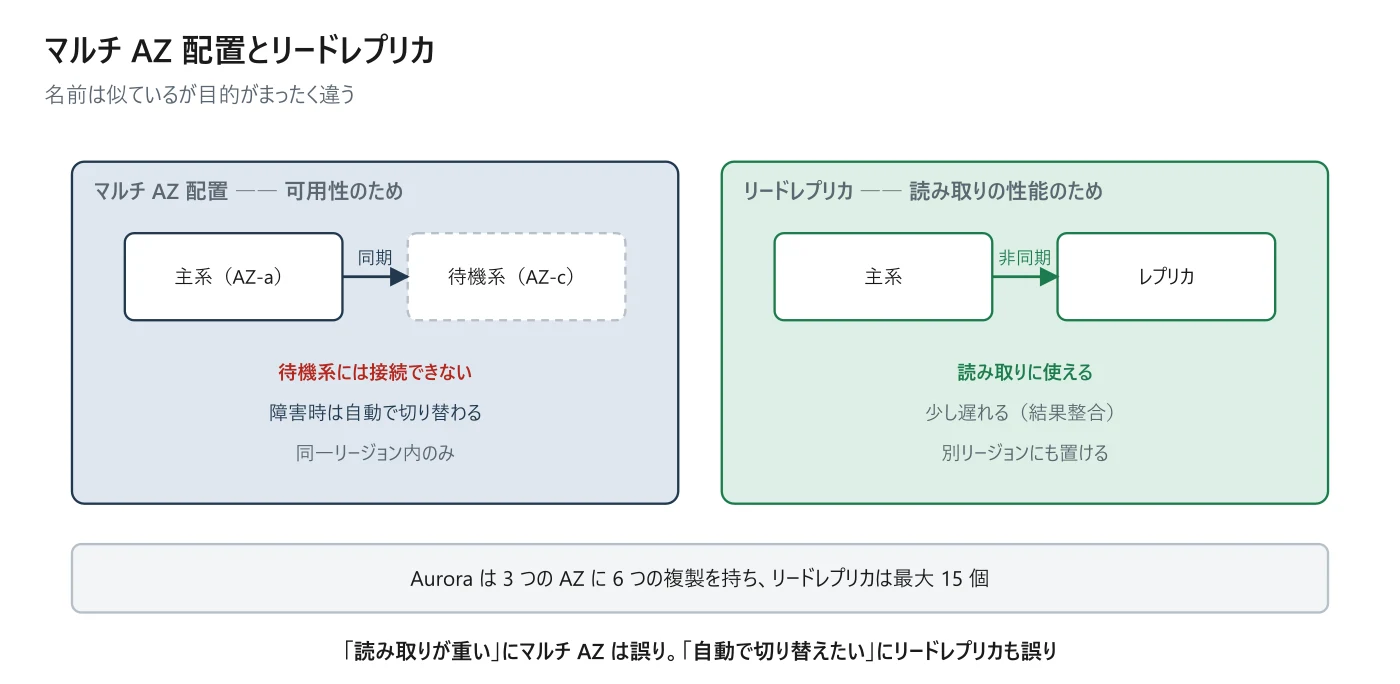
| マルチ AZ 配置 | リードレプリカ | |
|---|---|---|
| 目的 | 可用性(落ちないこと) | 読み取りの性能(分散) |
| 複製のしかた | 同期。待ってから応答を返す | 非同期。少し遅れる |
| ふだん使えるか | 待機系には接続できない | 読み取りに使える |
| 別リージョンに置けるか | 置けない(同一リージョン内) | 置ける |
| 障害時 | 自動で切り替わる(エンドポイントは同じ) | 手動で昇格させる |
試験では
「読み取りが重い」にマルチ AZ を選ぶのは誤り。待機系は読み取りにも使えない。逆に「障害時に自動で切り替えたい」にリードレプリカを選ぶのも誤り。両方を同時に使う構成はありえる。
補足
Amazon Aurora はさらに強い。3 つの AZ に 6 つの複製を持ち、リードレプリカは最大 15 個まで増やせる。書き込み先(ライターエンドポイント)と読み取り先(リーダーエンドポイント)が別の名前で用意されているので、アプリ側は接続先を変えるだけでよい。
AWS のサービスにはクォータ(上限)がある。上限を超えるとスロットリング(絞り込み)が起き、エラーが返る。設問は「急に失敗し始めた」という形で出る。
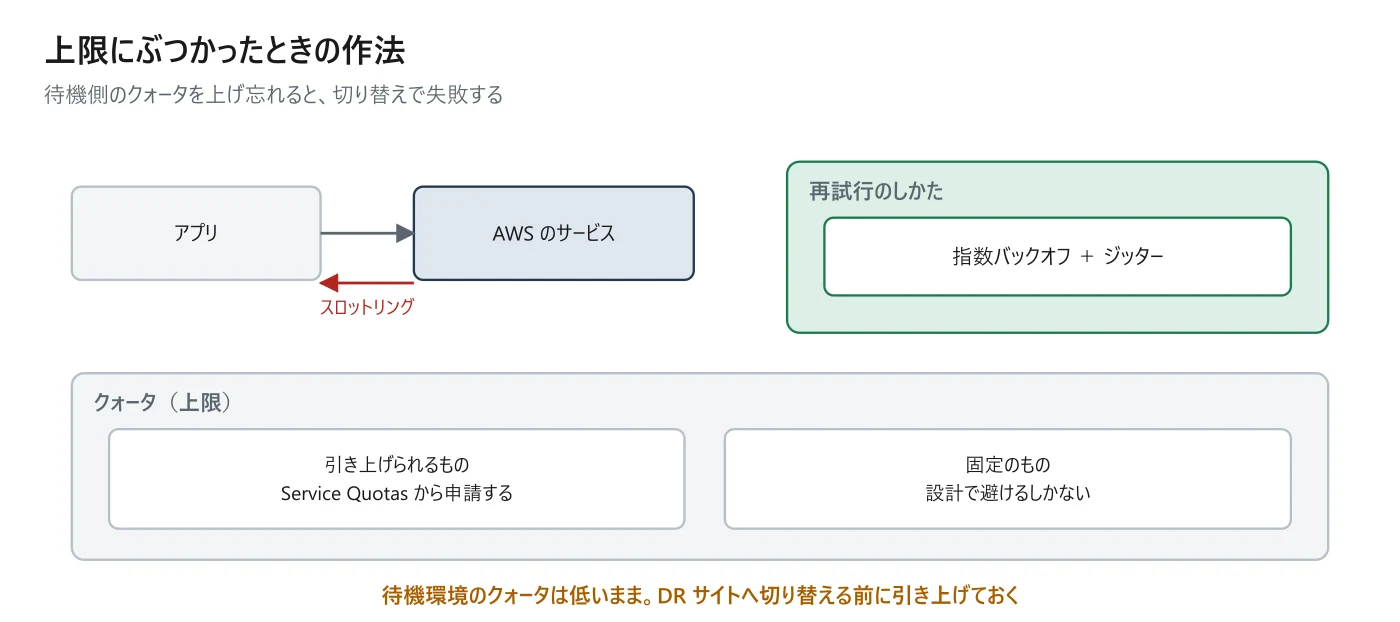
- 引き上げられるクォータと、固定のクォータがある。 前者は Service Quotas から申請する。
- 待機系の環境でもクォータを上げておく。 ふだん使っていないリージョンは上限が低いままなので、いざ切り替えたときに足りなくなる。
- 再試行は指数バックオフ+ジッターで行う。すぐ何度も再試行すると、混雑をさらに悪化させる。
- SDK は既定で再試行してくれる。 自分で書く前に設定を見る。
試験では
「DR サイトに切り替えたら起動できなかった」という設問の答えは「待機側のサービスクォータを事前に引き上げておく」。公式の試験ガイドにも、待機環境のクォータ設定が明記されている。
最後に 2 つ。気づくための道具と、直すときの考え方だ。
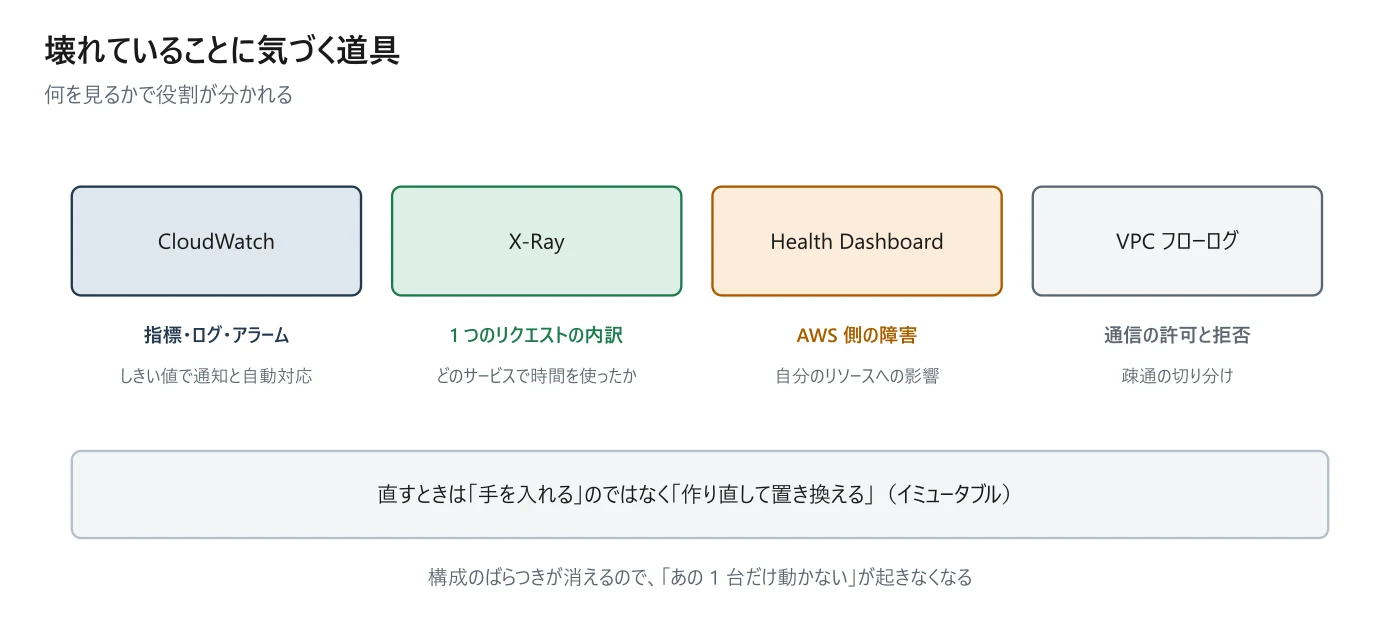
| 道具 | 分かること |
|---|---|
| Amazon CloudWatch | 指標とログとアラーム。しきい値を超えたら通知・自動対応 |
| AWS X-Ray | 1 つのリクエストがどのサービスで時間を使ったか(分散トレース) |
| AWS Health Dashboard | AWS 側の障害と、自分のリソースが影響を受けているか |
| VPC フローログ | 通信が通ったか・拒否されたか(疎通の切り分け) |
試験では
「構成がばらついて障害の原因が分からない」「手作業のパッチをやめたい」と書かれていたら、作り直す方向(ゴールデン AMI・起動テンプレート・Systems Manager でのパッチ管理)が答え。
イミュータブルにするには、同じ構成をもう一度作れることが前提になる。手で作った環境は再現できない。コードから作る。
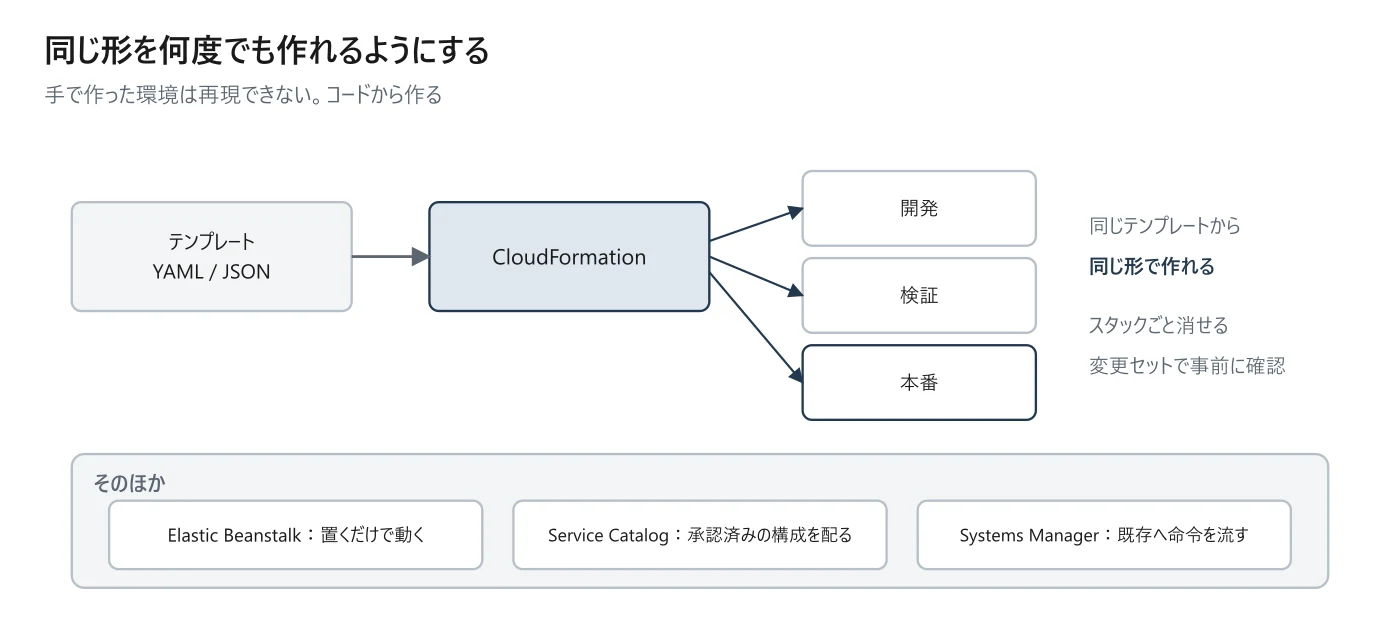
| 道具 | 何をするか | 向く場面 |
|---|---|---|
| AWS CloudFormation | インフラをテンプレートから作る | 構成そのものを再現したい |
| AWS Elastic Beanstalk | アプリを置くと環境ごと用意される | インフラを意識せず Web アプリを動かしたい |
| AWS Service Catalog | 承認済みの構成を一覧にして配る | 利用者に決まった形だけ作らせたい |
| AWS Proton | テンプレートを配って管理する(コンテナ・サーバーレス) | 基盤チームが型を配る |
| AWS Systems Manager | 既にある環境へ命令を流す(パッチ・設定・接続) | 運用の自動化 |
試験では
「同じ環境をもう一度作りたい」「構成をコードで管理したい」は CloudFormation。「アプリを置くだけで動かしたい」は Elastic Beanstalk。後者は裏で EC2 や ASG を作るが、利用者はそれを意識しない。「インフラを細かく制御したい」要件では Beanstalk は落ちる。
補足
AWS Well-Architected Tool は、自分の構成を 6 本の柱の観点で点検してくれる無料の道具だ。設計のレビューを定期的に行いたい、という要件で出てくる。
シナリオ演習
要件は「RTO 4 時間・RPO 1 時間」。リージョン障害に備えたいが、費用はできるだけ抑えたい。どの DR 戦略を選ぶか。
補足
答え:パイロットライト(データベースだけ別リージョンへ複製し、アプリは停止しておく)。
アクティブ/アクティブやウォームスタンバイは要件より速いが、そのぶん高い(やりすぎ)。バックアップと復元では RTO 4 時間に間に合わない可能性が高い(足りない)。
シナリオ演習
リージョン障害を想定した切り替え訓練をしたところ、待機リージョンで必要な台数の EC2 を起動できなかった。
補足
答え:待機リージョンのサービスクォータを事前に引き上げておく。
ふだん使っていないリージョンはクォータが既定のまま低い。公式の試験ガイドにも「待機環境のサービスクォータの設定」が明記されている。
この章のまとめ
- 高可用性と耐障害性の違い
- 高可用性の要件でまず見るところ
- NAT ゲートウェイを冗長化する方法
- Route 53 はリージョンに属するか
- 新しい版に 10% だけ流すルーティング
- 主系が不健康なら副系へ切り替えるルーティング
この章の根拠
最終確認 2026-10-04 / 対応バージョン DEA 2026-05-04 改訂版