第 14 章 Azure リソースの監視と管理(10〜15%)
リソースの監視
この章で学ぶこと
- Azure Monitor でメトリックを解釈する
- Azure Monitor でログ設定を構成する
- Azure Monitor でログのクエリと分析を行う
- Azure Monitor でアラート ルール、アクション グループ、アラート処理ルールを設定する
- Azure Monitor Insights を使用して仮想マシン、ストレージ アカウント、ネットワークの監視を構成して解釈する
この章に出てくる用語
- Azure Monitor
- Azure のリソースから「状態」と「出来事」を集めて、見る・調べる・通知する、までを一通り引き受ける監視基盤。 個別の監視ツールの集合ではなく、メトリック(数値)とログ(記録)という 2 つのデータの受け皿があり、その上にグラフ・クエリ・アラート・Insights が載っている、という構造になっている。Azure の外(オンプレミスや他社クラウド)からもデータを送れる。
- Log Analytics ワークスペース
- ログを実際にためておく入れ物。 Azure Monitor が集めたログはここに入り、保持期間と課金もこの単位で決まる。中身を検索・集計するための言語が KQL(Kusto クエリ言語)で、SQL に似た書き方でテーブルを絞り込んでいく。
Azure Monitor が扱うデータは 2 種類しかない。性格がはっきり違う。
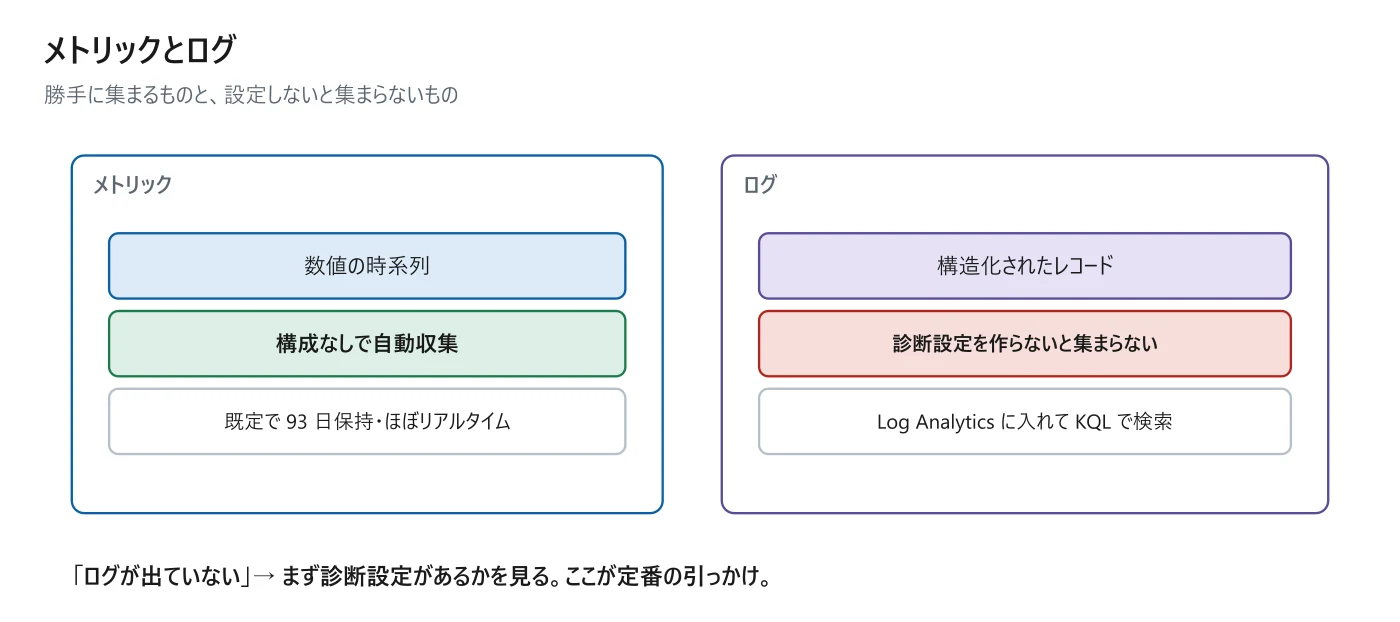
| メトリック | ログ | |
|---|---|---|
| データの形 | 数値の時系列 | 構造化されたレコード |
| 収集 | 自動(構成不要) | 診断設定が必要 |
| 既定の保持 | 93 日 | ワークスペースの設定による |
| 分析方法 | メトリックエクスプローラー | KQL(Kusto クエリ言語) |
| 速さ | ほぼリアルタイム | 取り込みに遅延がある |
試験では
「ログが出ていない」と書かれていたら、まず診断設定の有無を疑う。リソースを作っただけではリソースログは一切残らない。メトリックは勝手に集まるので、この違いが設問の分かれ目になる。
| 種類 | 何が記録されるか | 既定の保持 |
|---|---|---|
| アクティビティログ | サブスクリプションへの操作(誰が何をしたか) | 90 日 |
| リソースログ | リソース内部の動作 | 診断設定を作らないと残らない |
| ゲスト OS ログ | VM の中のイベントログや syslog | エージェント次第 |
試験では
アクティビティログは「リソースに対する操作」の記録であって、「リソースの中で起きたこと」ではない。「誰が VM を削除したか」→ アクティビティログ。「VM の中でアプリが落ちた」→ ゲスト OS ログ。
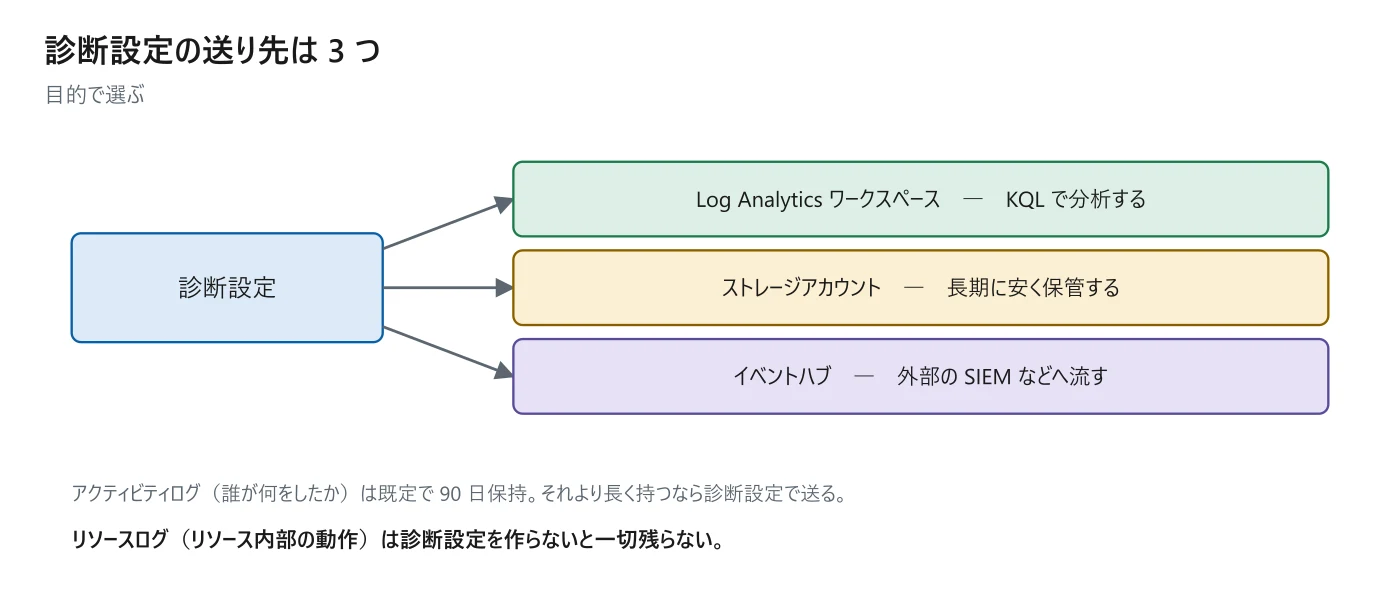
診断設定は、リソースのプラットフォームログとメトリックを外へ送る設定だ。送り先は 3 種類あり、目的で選ぶ。
| 送り先 | こう聞かれたら選ぶ |
|---|---|
| Log Analytics ワークスペース | KQL で検索・分析したい |
| ストレージアカウント | 長期に安く保管したい(コンプライアンス要件など) |
| イベントハブ | 外部の SIEM やサードパーティへ流したい |
# 診断設定を作る
az monitor diagnostic-settings create \
--name diag1 --resource <リソースID> \
--workspace <ワークスペースID> \
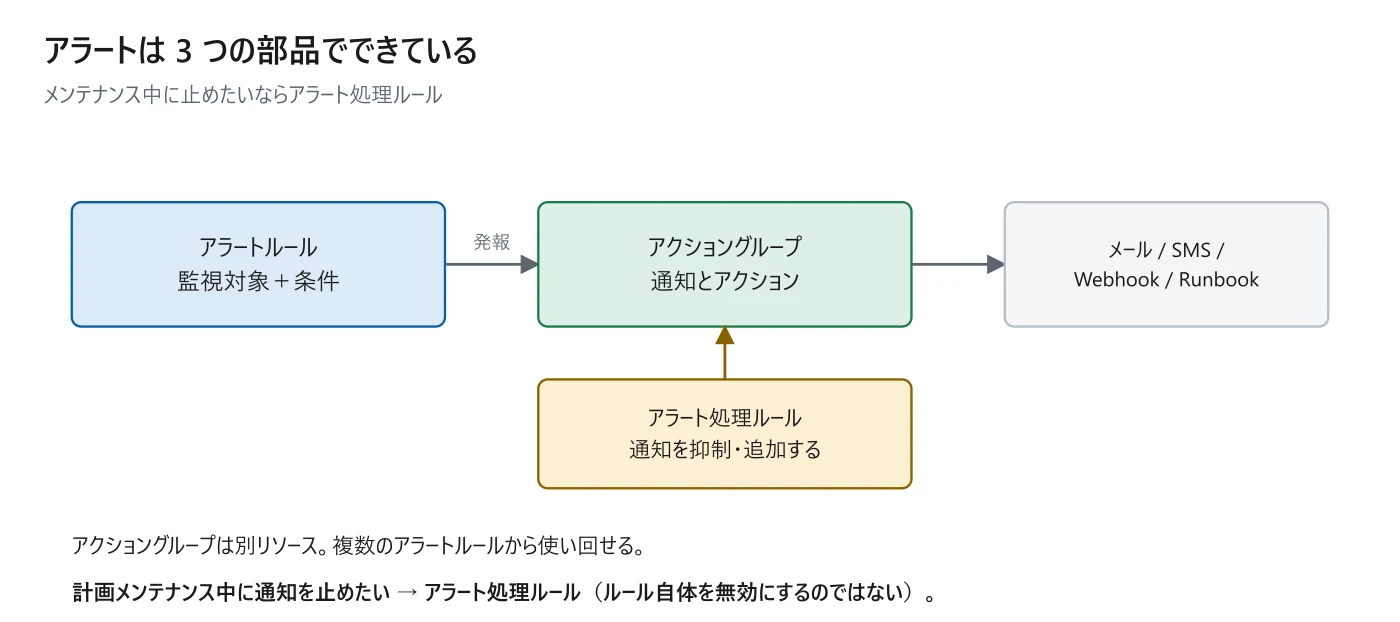
--logs '[{"category":"AuditLogs","enabled":true}]'アラートは 3 つの部品でできている。それぞれ別のリソースなので、「どれを作るべきか」が問われる。
| 部品 | 役割 |
|---|---|
| アラートルール | 監視対象と条件を定義する。重大度は Sev 0(最重大)〜 Sev 4 |
| アクショングループ | 発報時の通知(メール、SMS、プッシュ)とアクション(Webhook、Logic App、Runbook、Function)をまとめる |
| アラート処理ルール | 既存のアラートの通知を抑制したり、別のアクショングループを追加したりする |
試験では
計画メンテナンス中に通知を止めたい → アラート処理ルール。アラートルール自体を無効にしてしまうと、戻し忘れる危険があるうえ、その期間のアラート自体が記録されない。処理ルールなら通知だけを止められる。
補足
アクショングループはアラートルールとは別のリソースで、複数のアラートルールから使い回せる。「通知先を一か所で管理したい」という要件はこれで満たす。
アラートにはメトリックアラート(しきい値超過。反応が速い)とログアラート(KQL のクエリ結果が条件に一致)がある。
試験では
「VM が応答しなくなったら通知したい」→ Heartbeat テーブルをログアラートで監視する。メトリックアラートではない。Azure Monitor エージェントが 1 分ごとに送る生存信号が Heartbeat テーブルに記録されるので、それが途切れたことを検知する。
Insights は、よく使う監視を事前構成したダッシュボードとして提供する機能群だ。
- VM Insights ―― CPU・メモリ・ディスク・ネットワークに加え、プロセス間の依存関係マップを可視化する。エージェントのインストールが必要
- Storage Insights ―― ストレージアカウントの状態をダッシュボードで見る
- Network Insights ―― ネットワークリソースの状態と接続性をまとめて見る
VM からログとメトリックを集める現行のエージェントは Azure Monitor エージェント(AMA)で、何を集めるかはデータ収集規則(DCR)で定義する。旧 Log Analytics エージェント(MMA)からの移行が進んでいる。
第 11 章で見た Network Watcher の道具のうち、この章の出題項目に明示されているのが接続モニターだ。
試験では
「一時的に確認したい」なら接続トラブルシューティング、「継続的に監視したい」なら接続モニター。問題文の時間軸で選び分ける。
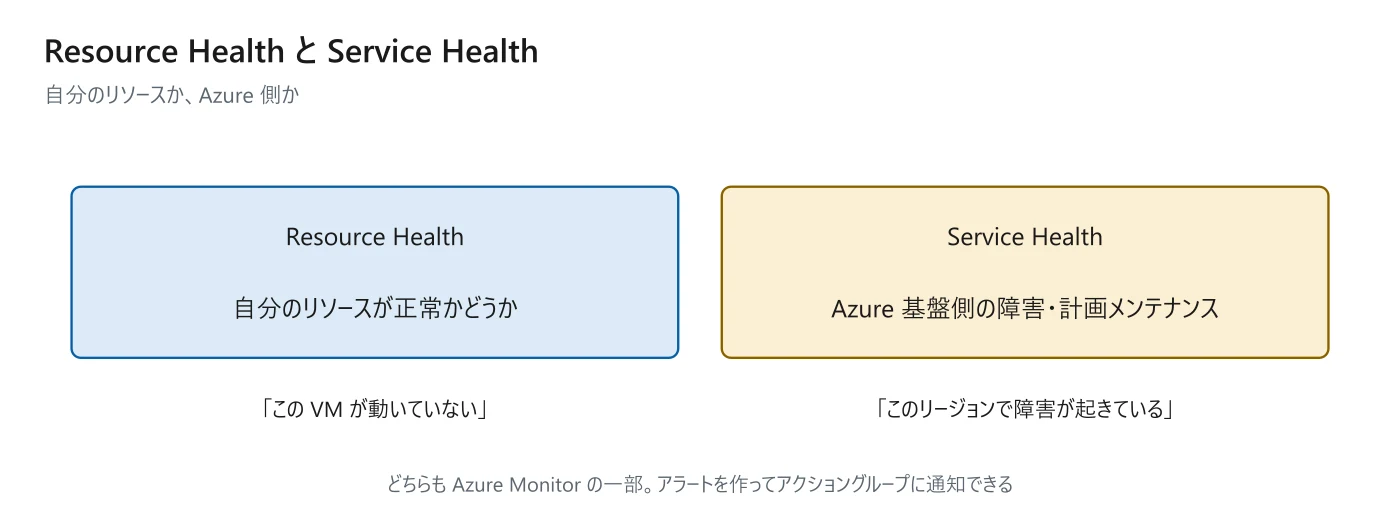
名前が似ていて混同しやすいが、見ている対象が違う。
試験では
自分のリソースの状態は Resource Health、Azure 基盤側の問題は Service Health。「Azure 側の障害や計画メンテナンスを知りたい」→ Service Health アラートを作る。どちらも Azure Monitor の一部で、アクショングループに通知できる。
この章のまとめ
- 構成なしで自動収集されるのはどちらか
- 診断設定を作らないと集まらないのはどちらか
- メトリックの既定の保持期間
- アクティビティログの既定の保持期間
- アクティビティログに記録されるもの
- 診断設定の送り先 3 種類