第 7 章 高パフォーマンスなアーキテクチャの設計(24%)
コンピューティングの選び方
この章で学ぶこと
- 適切なユースケースを伴う AWS のコンピューティングサービス(AWS Batch、Amazon EMR、Fargate)
- AWS のグローバルインフラストラクチャとエッジサービスが支える分散コンピューティング
- 適切なユースケースを伴うスケーラビリティの機能(EC2 Auto Scaling、AWS Auto Scaling)
- サーバーレスの技術とパターン(Lambda、Fargate)
- コンテナのオーケストレーション(ECS、EKS)
この章に出てくる用語
- コールドスタート
- しばらく呼ばれていない関数が、初回に実行環境を作るぶんだけ遅くなる現象。 ランタイムの起動と初期化のぶんで、数百ミリ秒〜数秒かかることがある。応答時間が厳しい API では、プロビジョニング済み同時実行で温めておく。Java では SnapStart という仕組みもある。
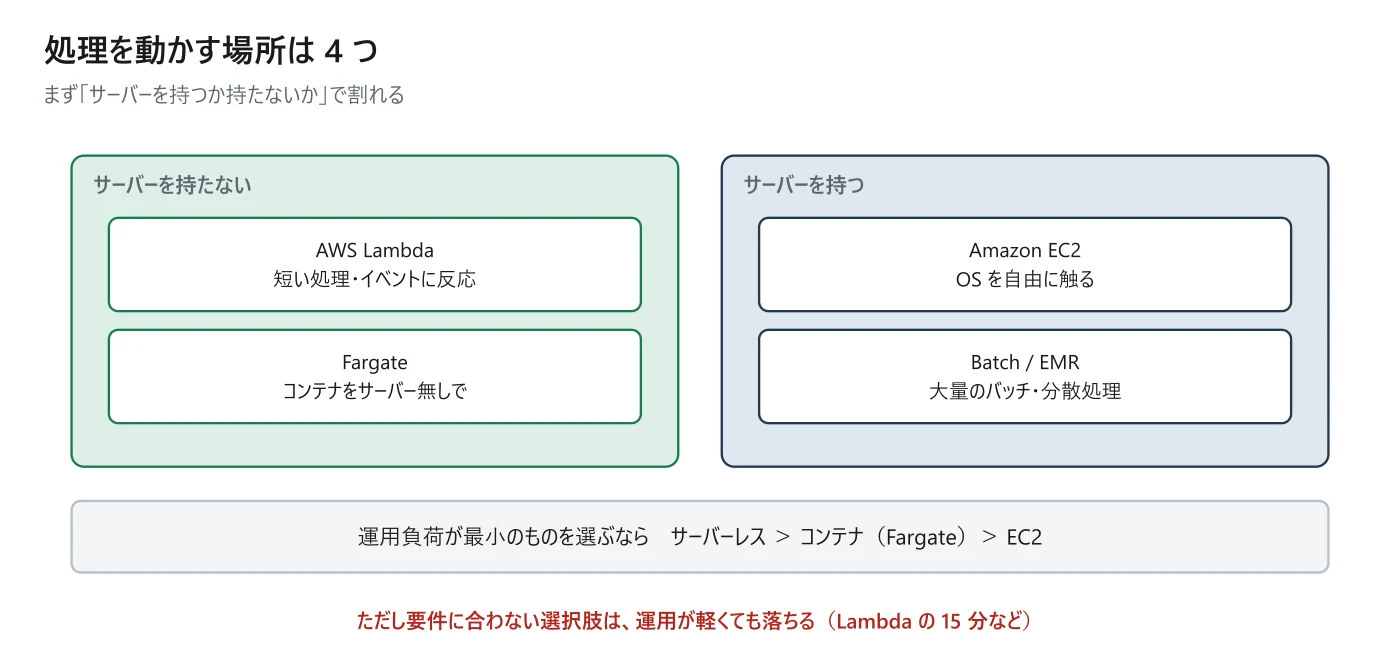
| 選択肢 | 向く場面 | 向かない場面 |
|---|---|---|
| AWS Lambda | 短い処理・イベントに反応・使用量に波がある | 15 分を超える処理・常時高負荷 |
| コンテナ(ECS / EKS / Fargate) | 既存のコンテナ資産・長く動く処理・起動が速い | OS レベルの細かい制御が要る |
| Amazon EC2 | OS を自由に触る・特殊なライセンス・常時稼働 | 運用の手間を減らしたいとき |
| 特化したサービス(Batch・EMR) | 大量のバッチ処理・分散データ処理 | 小さな処理・常時稼働の API |
試験では
SAA の設問は「運用負荷が最小のものを選べ」が多い。その場合の優先順は サーバーレス > コンテナ(Fargate)> EC2 になる。ただし要件に合わない選択肢は運用が軽くても落ちる(Lambda の 15 分など)。
インスタンスタイプの名前には意味がある。m6i.large なら「ファミリー m・第 6 世代・Intel・サイズ large」だ。ファミリーの文字だけ覚えれば、設問の要件と突き合わせられる。
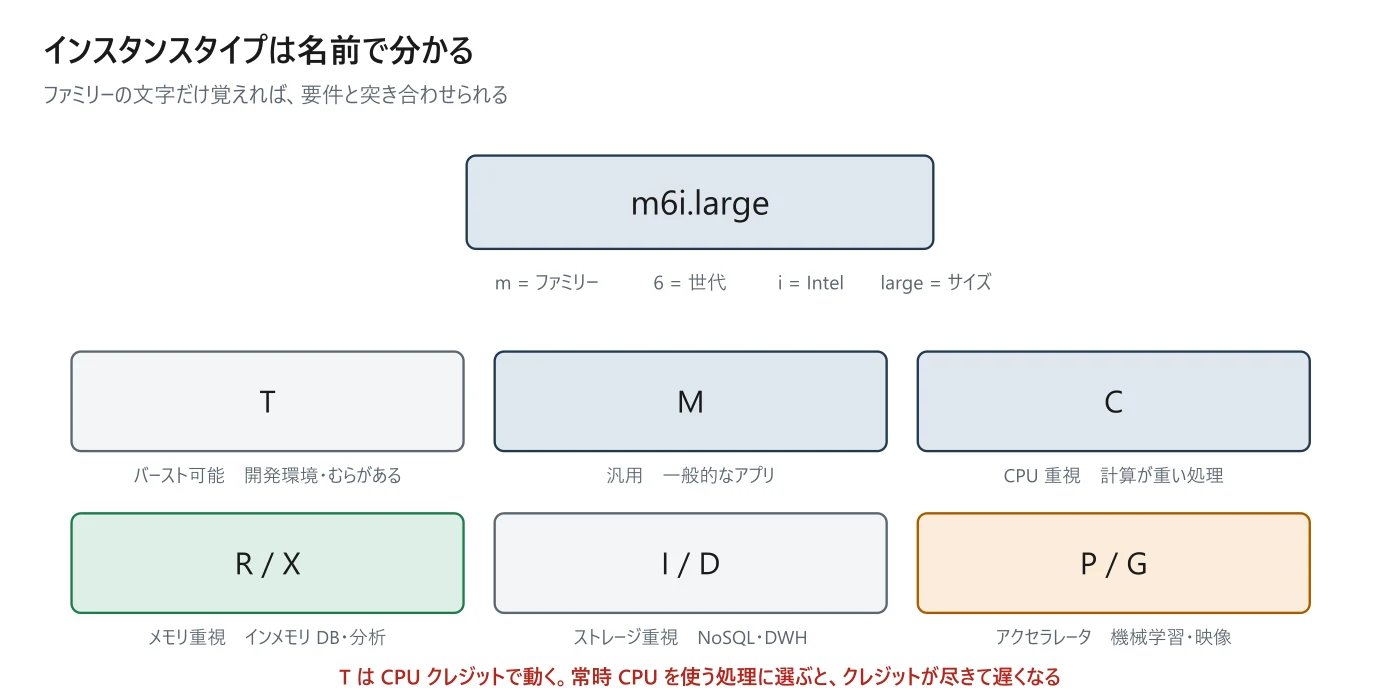
| ファミリー | 性格 | 向く用途 |
|---|---|---|
| T(t3・t4g) | バースト可能。ふだんは低く、必要なときだけ上がる | 開発環境・小さな Web・アクセスにむらがある |
| M(m6i・m7g) | 汎用。CPU とメモリのバランス | 一般的なアプリサーバー |
| C(c6i・c7g) | CPU 重視 | 計算が重い処理・バッチ・ゲームサーバー |
| R / X / z | メモリ重視 | インメモリ DB・大きなキャッシュ・分析 |
| I / D / H | ストレージ重視(高速なローカルディスク) | NoSQL・データウェアハウス |
| P / G / Inf / Trn | アクセラレータ(GPU など) | 機械学習の学習と推論・映像処理 |
補足
T シリーズは CPU クレジットで動く。ふだん使わなかったぶんが貯まり、必要なときに使える。クレジットが尽きると性能が落ちるので、常時 CPU を使う処理に T を選ぶのは誤りになる。(クレジットを超えて使い続ける「無制限モード」もあるが、追加料金がかかる。)
試験では
要件の語とファミリーは直結する。「メモリ内で大量のデータを保持」なら R、「計算が重い」なら C、「機械学習の学習」なら P や Trn。ここを合わせられれば、選択肢の半分は消える。
インスタンスを物理的にどう配置するかを指定できる。狙いが 3 つあり、それぞれ逆の方向を向いている。
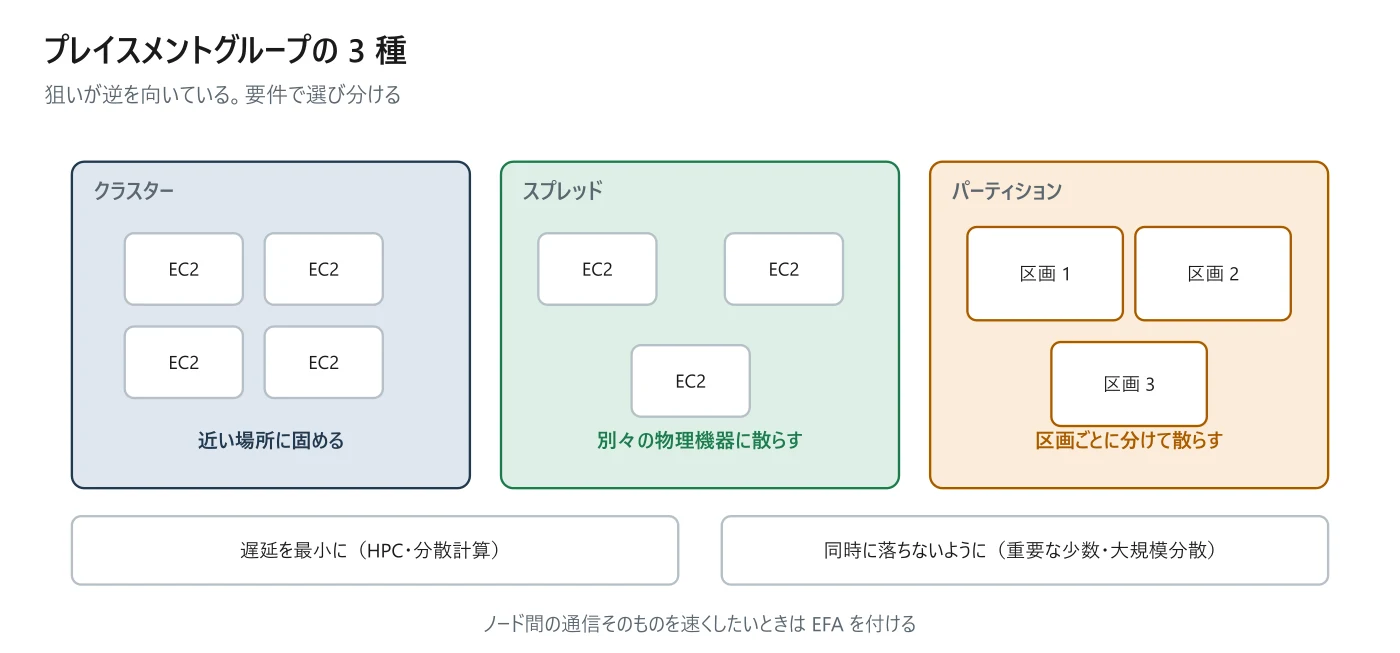
| 種類 | 何をするか | 狙い |
|---|---|---|
| クラスター | 同じ AZ の近い場所に固める | ノード間の遅延を最小に(HPC・分散計算) |
| スプレッド | 別々の物理ハードウェアに散らす | 同時に落ちないようにする(少数の重要なインスタンス) |
| パーティション | 区画ごとに分けて散らす | 大規模な分散システム(HDFS・Cassandra など) |
補足
ノード間の通信そのものを速くしたいときは EFA(Elastic Fabric Adapter) を付ける。HPC や分散学習で MPI を使うような場面で問われる。ふつうのネットワーク性能は ENA(拡張ネットワーキング)が担う。
第 4 章で Auto Scaling の仕組みを見た。ここでは何を見て増やすかを詰める。
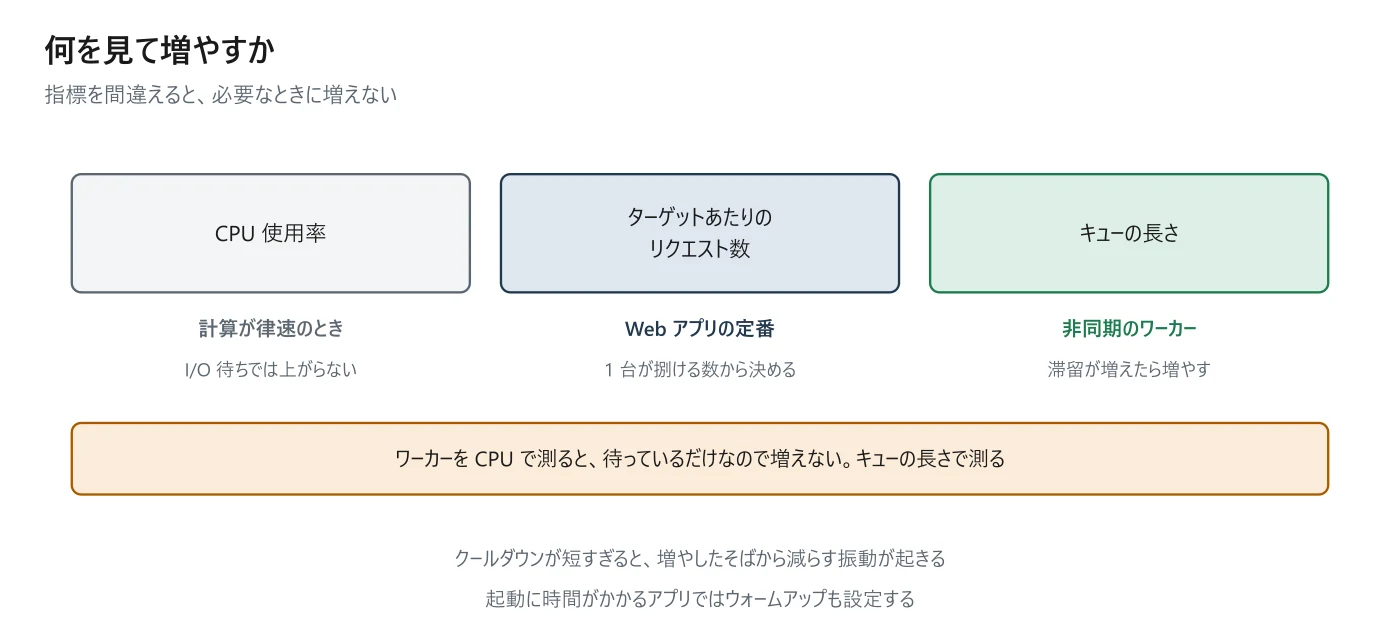
| 指標 | 向く場面 | 注意 |
|---|---|---|
| CPU 使用率 | 計算が律速のとき | I/O 待ちが多いアプリでは上がらない |
| ターゲットあたりのリクエスト数 | Web アプリの定番 | ALB の指標。1 台が捌ける数から決める |
| キューの長さ(SQS) | 非同期のワーカー | 滞留が増えたら増やす。処理の遅れに直結する |
| カスタム指標 | アプリ固有の待ち行列など | CloudWatch に送って使う |
試験では
キューの長さでスケールさせるのは、ワーカー型の定番の答え。CPU で測ると、待っているだけのワーカーは CPU が低いままなので増えない。「メッセージが滞留する」という設問ではここを見る。
補足
増減のたびに揺れないよう、クールダウン(次の調整までの待ち時間)がある。短すぎると増やしたそばから減らす振動が起きる。起動に時間がかかるアプリでは、ウォームアップの設定も効く。
Lambda は設定項目が少ないぶん、効くつまみも少ない。問われるのは 3 つだ。
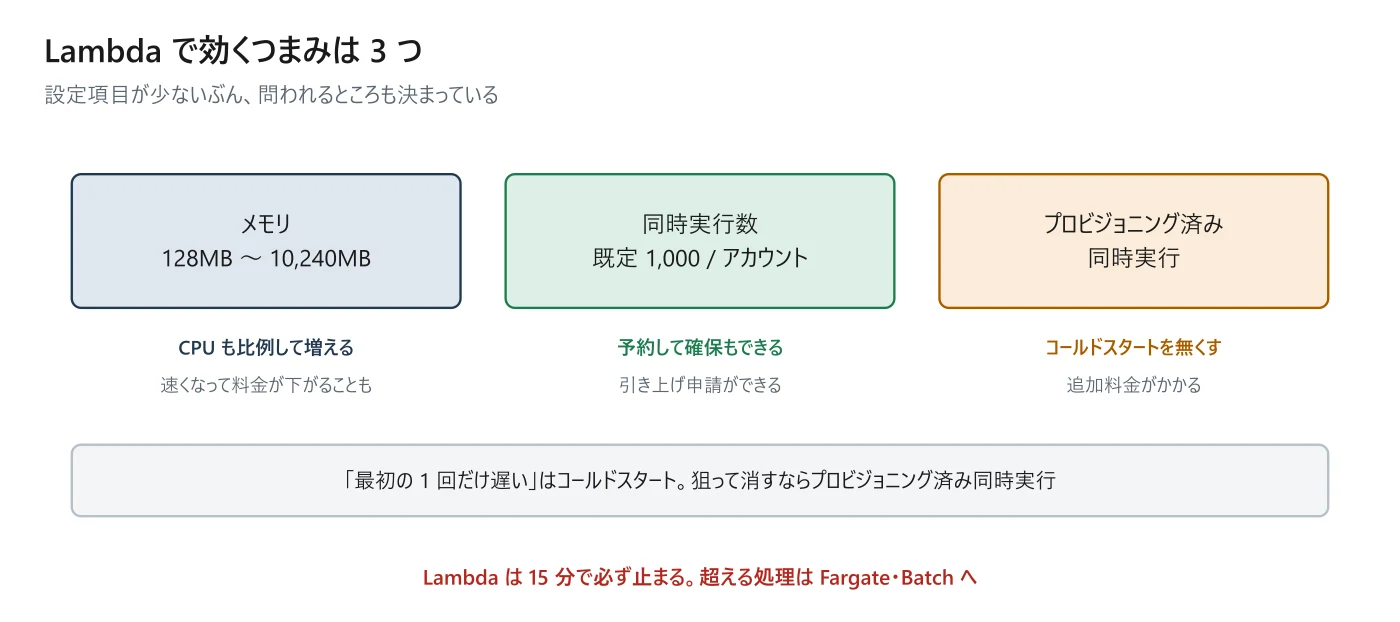
| つまみ | 何が変わるか | 押さえること |
|---|---|---|
| メモリ(128MB〜10,240MB) | CPU も比例して増える | 増やすと速くなり、合計料金はむしろ下がることがある |
| 同時実行数 | 同時に動ける数 | アカウントで既定 1,000(引き上げ可)。予約して確保もできる |
| プロビジョニング済み同時実行 | コールドスタートを無くす | あらかじめ温めておく。追加料金がかかる |
試験では
「たまに応答が遅い」「最初の 1 回だけ遅い」はコールドスタート。メモリを増やす選択肢も一緒に並ぶが、狙って消すならプロビジョニング済み同時実行。
| サービス | 何をするか | 向く場面 |
|---|---|---|
| AWS Batch | ジョブを並べて、必要な分だけ計算資源を用意して流す | 夜間の大量バッチ・科学計算。スポットと相性がよい |
| Amazon EMR | Hadoop / Spark のクラスターをマネージドで立てる | 大規模なデータ処理・ETL(第 10 章) |
| Amazon EC2 Auto Scaling | EC2 の台数を増減させる | 一般的なサーバー群 |
| AWS Auto Scaling | 複数のサービスをまとめてスケール計画で扱う | EC2・DynamoDB・Aurora などを横断して |
試験では
「EC2 Auto Scaling」と「AWS Auto Scaling」は別物。前者は EC2 の台数、後者は複数サービスを横断した計画。選択肢に両方並ぶことがある。
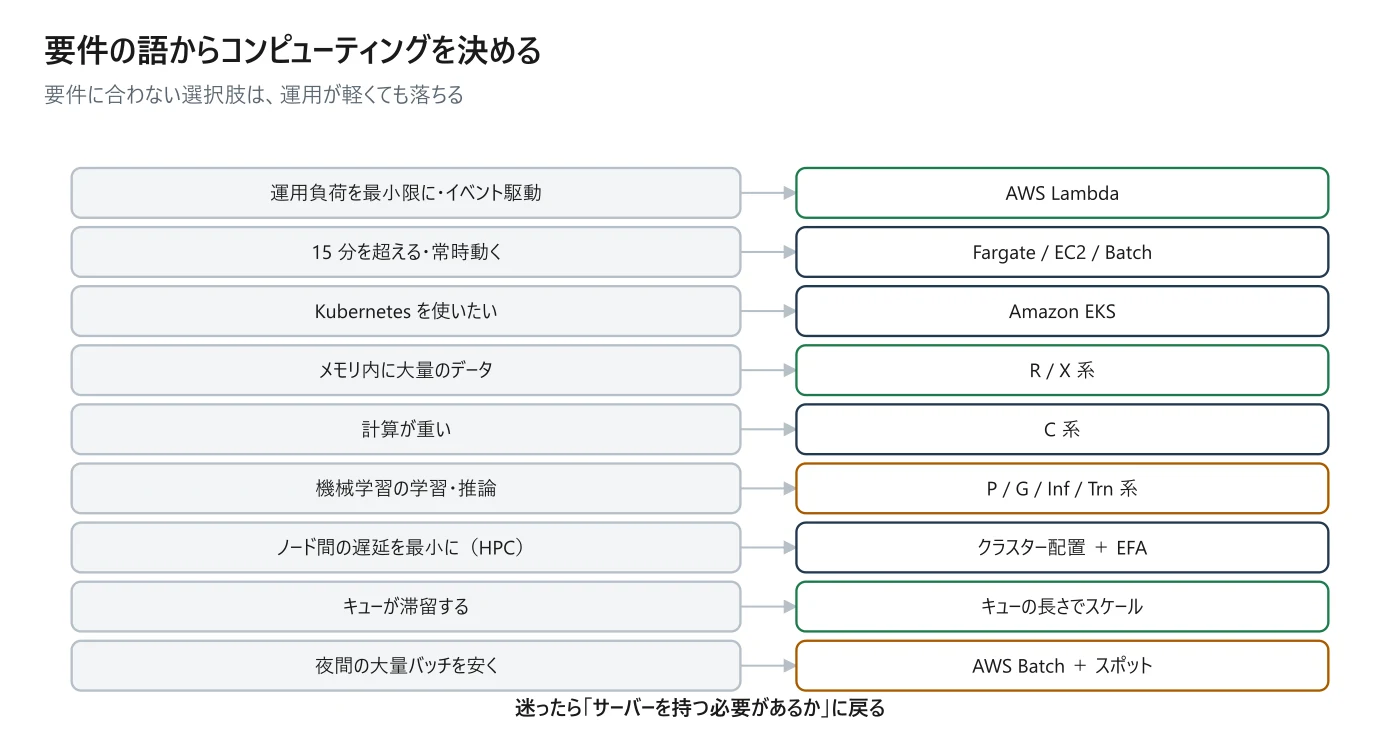
| 問題文に出る語 | 答えの方向 |
|---|---|
| 運用負荷を最小限に・イベントに反応して | AWS Lambda |
| 15 分を超える・常時動く処理 | Fargate / EC2 / Batch |
| Kubernetes を使いたい | Amazon EKS |
| サーバーの管理をやめたいがコンテナは使う | AWS Fargate |
| メモリ内に大量のデータ | R / X 系インスタンス |
| 計算が重い・CPU 律速 | C 系インスタンス |
| 機械学習の学習・推論 | P / G / Inf / Trn 系 |
| ノード間の遅延を最小にしたい(HPC) | クラスタープレイスメントグループ+ EFA |
| 同時に落ちないように散らしたい | スプレッドプレイスメントグループ |
| キューが滞留する | キューの長さでスケールさせる |
| 最初の 1 回だけ遅い | プロビジョニング済み同時実行 |
| 夜間の大量バッチを安く | AWS Batch + スポット |
シナリオ演習
SQS のワーカーを EC2 Auto Scaling で動かしている。キューにメッセージが溜まっても台数が増えない。CPU 使用率は 20% のままだ。
補足
答え:スケーリングの指標を、キューに溜まっているメッセージ数(または 1 台あたりのバックログ)に変える。
待ち時間が長いワーカーは CPU が上がらないので、CPU 使用率では増えない。指標の選び方そのものが誤っている。
シナリオ演習
社内向けの API が、しばらく使われないあとの最初のリクエストだけ 3 秒かかる。Lambda で実装されている。
補足
答え:プロビジョニング済み同時実行を設定して、実行環境を温めておく。
コールドスタートが原因。メモリを増やすと多少速くはなるが、初回の初期化そのものは消えない。
この章のまとめ
- 運用負荷が最小のものを選ぶときの優先順
- m6i.large の m と 6 の意味
- バースト可能なファミリー
- 常時 CPU を使う処理に T を選ぶのは
- メモリ重視のファミリー
- CPU 重視のファミリー
この章の根拠
最終確認 2026-10-04 / 対応バージョン DEA 2026-05-04 改訂版