第 8 章 高パフォーマンスなアーキテクチャの設計(24%)
データベースの選び方
この章で学ぶこと
- キャッシュの戦略とサービス(ElastiCache)
- データのアクセスパターン(読み取り中心と書き込み中心)
- データベースのキャパシティプランニング(キャパシティユニット、インスタンスタイプ、Provisioned IOPS)
- データベースの接続とプロキシ
- 適切なユースケースを伴うデータベースエンジン
この章に出てくる用語
- Amazon RDS
- MySQL・PostgreSQL・MariaDB・Oracle・SQL Server などを、AWS が運用してくれる形で動かすサービス。 OS とデータベースエンジンのパッチ、バックアップ、マルチ AZ 配置による切り替えを AWS 側が面倒を見る。OS にはログインできない。 それが必要なら EC2 に自分で入れる(その場合は運用も自分持ち)。
- Amazon DynamoDB
- キーで引くことに特化した、サーバーレスのデータベース。 テーブルの容量に上限が無く、どれだけ大きくなっても一桁ミリ秒で返す。そのかわり、結合(JOIN)はできないし、どう引くかを先に決めてからテーブルを設計する必要がある。
- Amazon RDS Proxy
- 接続をまとめて使い回し、データベースの接続数を節約する仕組み。 Lambda のように短い処理が大量に立ち上がるとき、そのたびに接続すると上限に達して「接続できない」エラーが出る。プロキシを挟むと接続が再利用され、フェイルオーバー時の切り替えも速くなる。
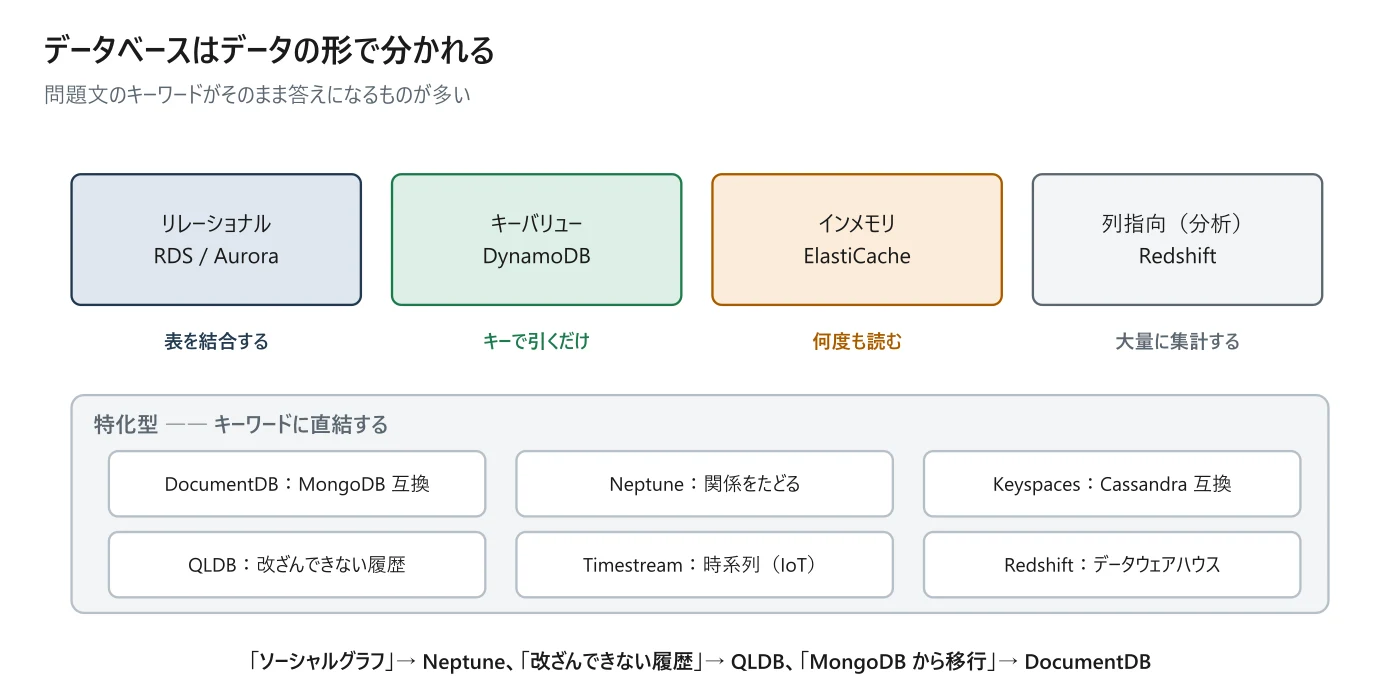
| 形 | 代表 | 向く場面 |
|---|---|---|
| リレーショナル | RDS / Aurora | 表と表を結合する。トランザクションが要る |
| キーバリュー | DynamoDB | キーで引くだけ。極端に大きい・速い |
| インメモリ | ElastiCache | 同じものを何度も読む。セッション・ランキング |
| 列指向(分析) | Redshift | 大量のデータを集計する(第 10 章) |
| 文書 | DocumentDB | MongoDB 互換の JSON 文書 |
| グラフ | Neptune | 関係をたどる(SNS の友達・推薦) |
| ワイドカラム | Keyspaces | Cassandra 互換 |
| 台帳 | QLDB | 変更履歴を改ざんできない形で残す |
| 時系列 | Timestream | IoT の計測値など時刻の並び |
試験では
特化型のデータベースは「問題文のキーワードに直結する」。「ソーシャルグラフ」「関係をたどる」→ Neptune、「改ざんできない履歴」→ QLDB、「MongoDB からの移行」→ DocumentDB。ここは覚えるだけで点になる。
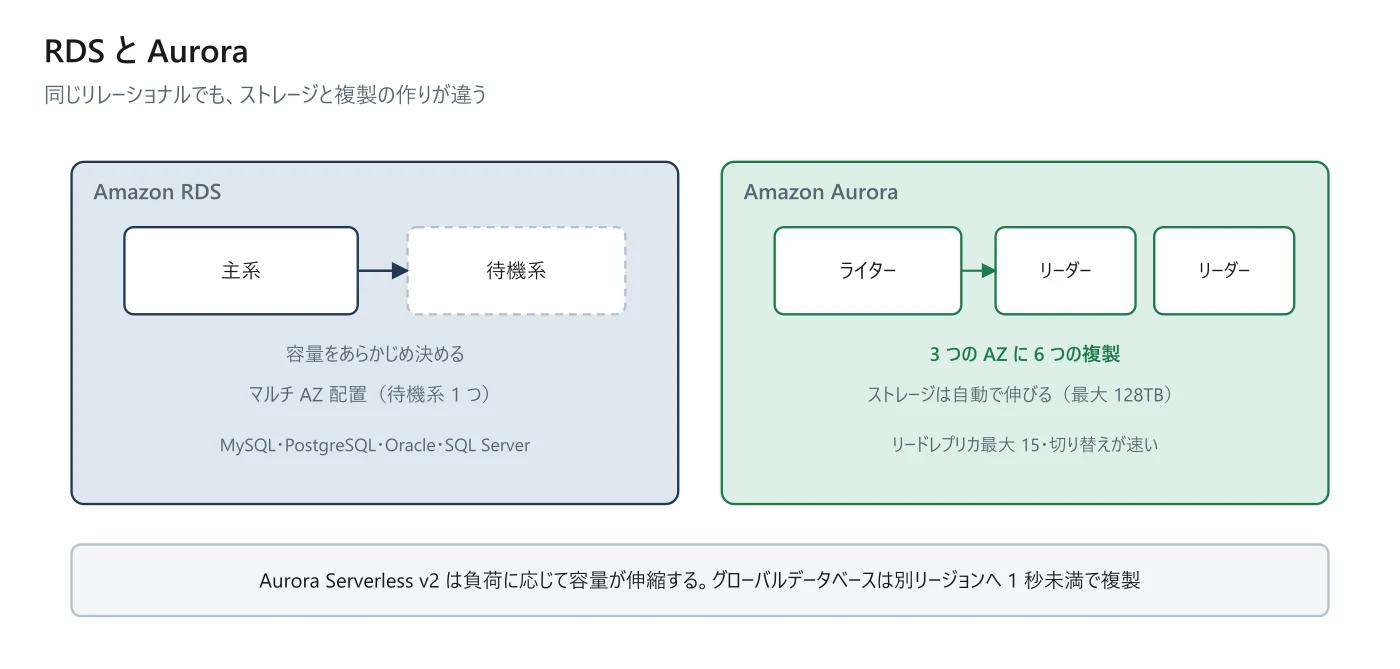
| Amazon RDS | Amazon Aurora | |
|---|---|---|
| エンジン | MySQL・PostgreSQL・Oracle・SQL Server など | MySQL / PostgreSQL 互換 |
| ストレージ | 容量をあらかじめ決める | 自動で伸びる(最大 128TB) |
| 複製 | マルチ AZ 配置(同期の待機系 1 つ) | 3 つの AZ に 6 つの複製 |
| リードレプリカ | エンジンにより最大 5〜15 | 最大 15・遅延が小さい |
| 切り替え | 数十秒〜 | より速い |
| 費用 | 安い | 高い(そのぶん性能と可用性が高い) |
補足
Aurora Serverless v2 は、負荷に応じて容量を自動で増減させる形だ。アクセスに波がある・読めないワークロードで、「ピークに合わせて常時大きいインスタンスを立てる」のを避けられる。コストの設問(第 13 章)でも出てくる。
リージョンをまたぐときは Aurora グローバルデータベースがある。別リージョンへの複製が 1 秒未満で、障害時は 1 分ほどで昇格できる。「複数リージョンで読みたい」「リージョン障害に備えたい」要件で出る。
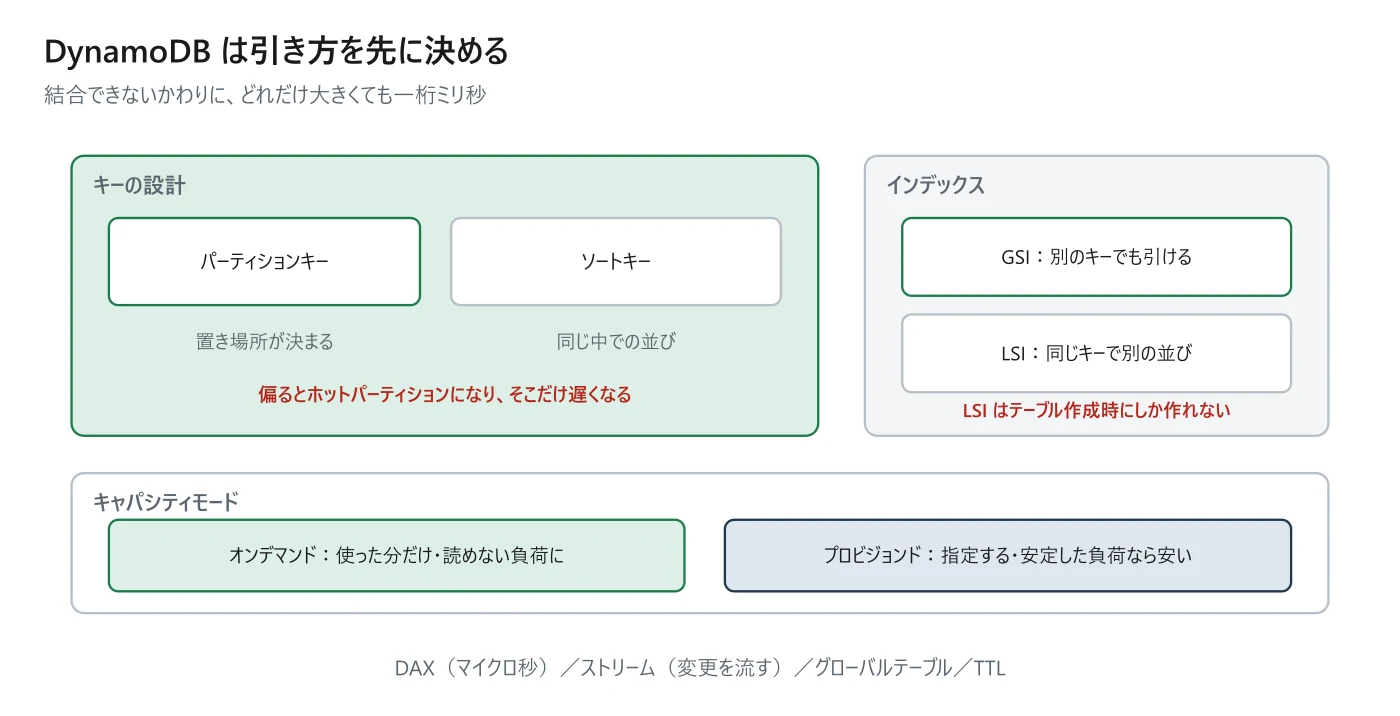
| 要素 | 何を決めるか | つまずきどころ |
|---|---|---|
| パーティションキー | データの置き場所が決まる | 偏ると「ホットパーティション」になり、そこだけ遅くなる |
| ソートキー | 同じパーティション内の並び | 範囲で引くときに効く |
| GSI(グローバルセカンダリインデックス) | 別のキーでも引けるようにする | あとから追加できる。結果整合のみ |
| LSI(ローカルセカンダリインデックス) | 同じパーティションキーで別の並び | テーブル作成時にしか作れない |
| キャパシティモード | どう決まるか | 向く場面 |
|---|---|---|
| オンデマンド | 使った分だけ。事前の見積り不要 | 読めない負荷・急な山 |
| プロビジョンド | 読み書きの容量をあらかじめ指定(Auto Scaling 可) | 安定した負荷。安くなる |
- DAX ―― DynamoDB 専用のキャッシュ。読み取りがマイクロ秒になる。
- ストリーム ―― 変更を順に流す。Lambda と繋いで変更に反応できる。
- グローバルテーブル ―― 複数リージョンで読み書きできるようにする。
- TTL ―― 項目に期限を持たせ、過ぎたら自動で消す。
試験では
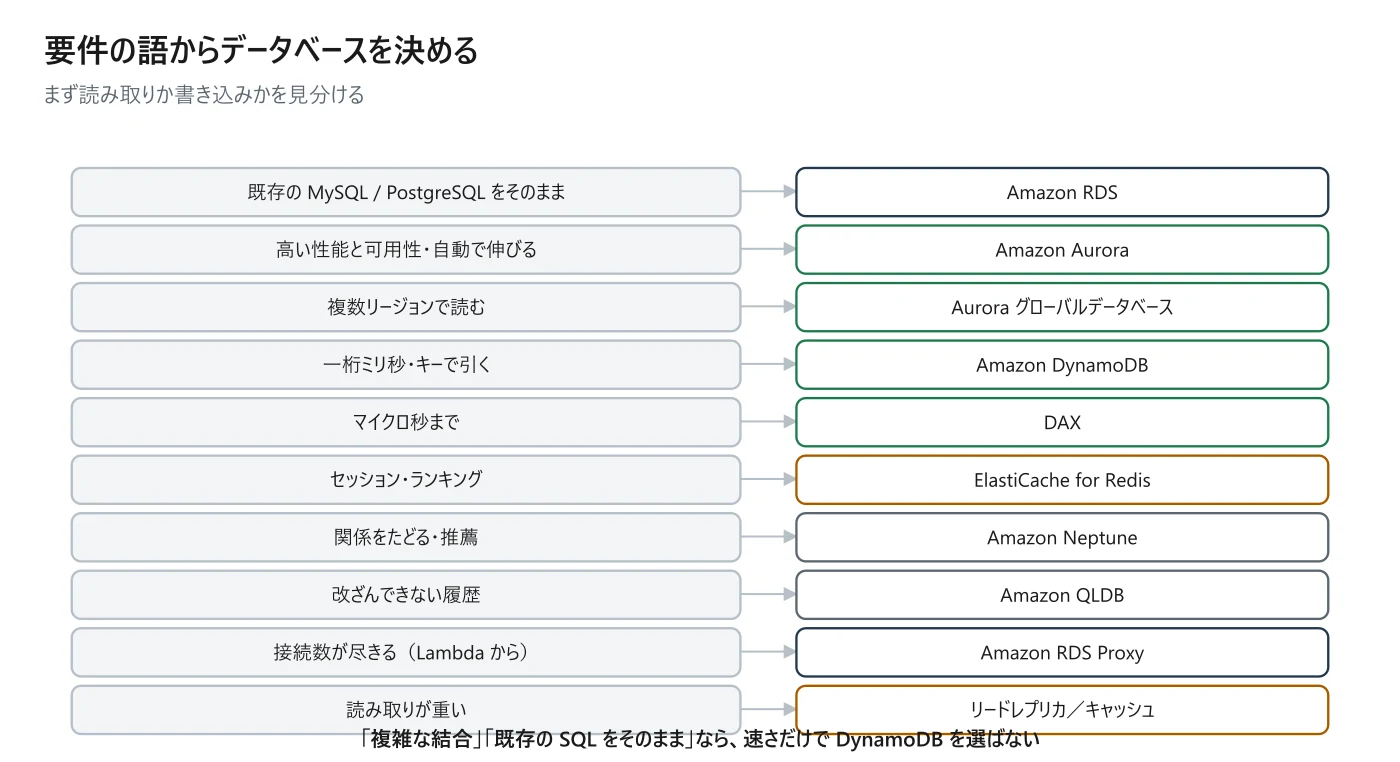
「数ミリ秒」「キーで引くだけ」「サーバーレス」は DynamoDB。「マイクロ秒」まで求められたら DAX。逆に「複雑な結合をしたい」「既存の SQL をそのまま使いたい」なら RDS / Aurora。
同じ結果を何度も返しているなら、データベースの手前にキャッシュを置く。ElastiCache には 2 つのエンジンがあり、性格が違う。
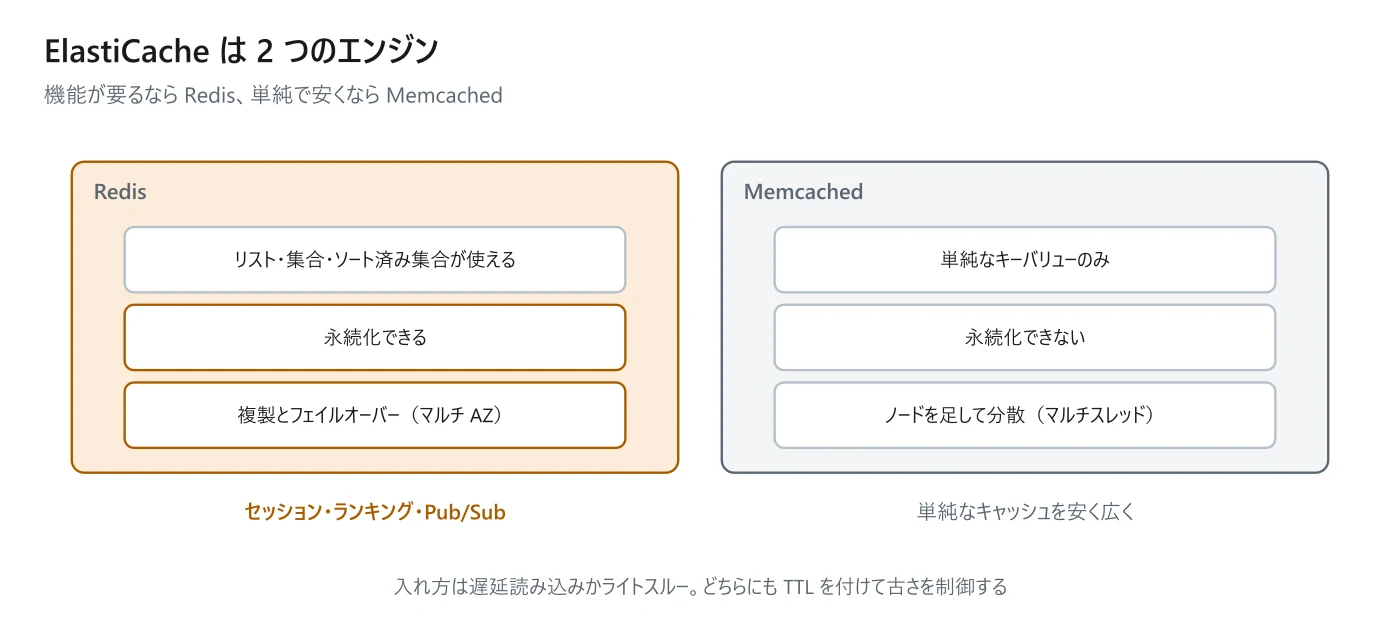
| Redis | Memcached | |
|---|---|---|
| データ構造 | 豊富(リスト・集合・ソート済み集合) | 単純なキーバリューのみ |
| 永続化 | できる | できない |
| 複製とフェイルオーバー | できる(マルチ AZ) | できない |
| スケールのしかた | シャーディング(クラスターモード) | ノードを足して分散(マルチスレッド) |
| 向く場面 | セッション・ランキング・Pub/Sub | 単純なキャッシュを安く広く |
補足
キャッシュの入れ方は 2 通りある。遅延読み込み(Lazy Loading)は、まずキャッシュを見て無ければ DB から読んで入れる方式。ライトスルーは、書き込みのたびにキャッシュも更新する方式だ。前者は無駄が少ないが初回が遅く、後者は常に新しいが書き込みが重くなる。どちらにも TTL を付けて古さを制御する。
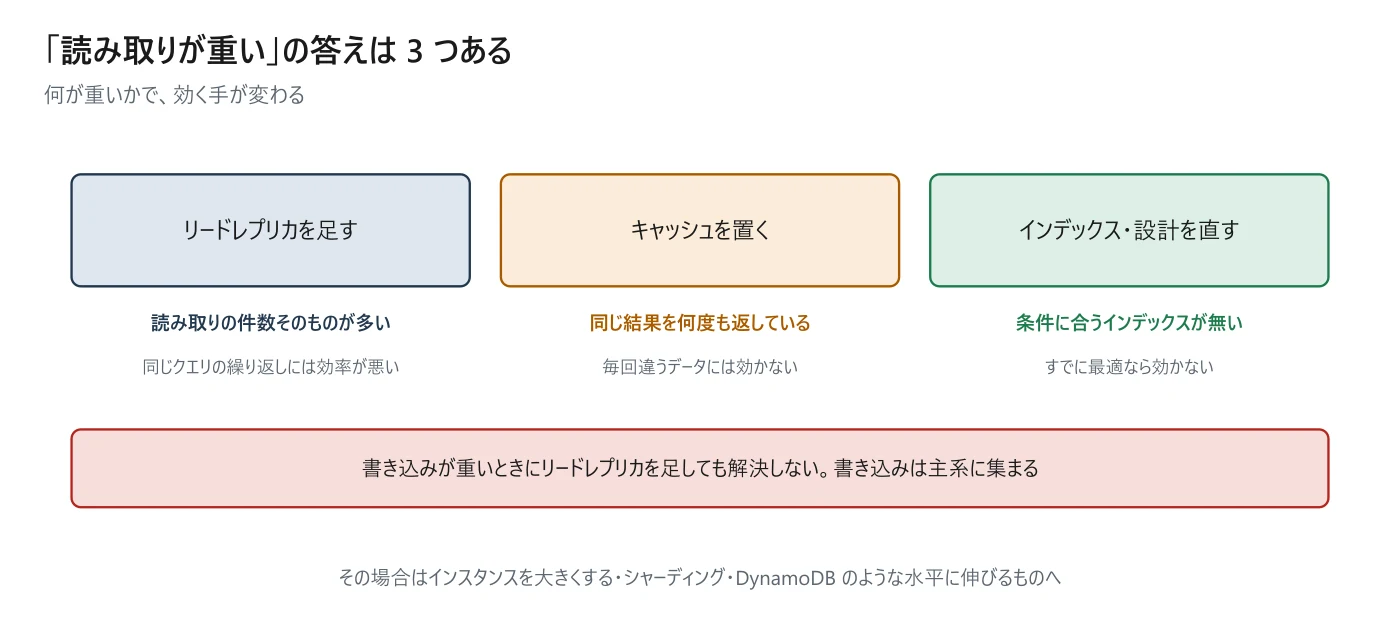
「読み取りが重い」という設問には、3 つの答え方がある。どれが正解かは、何が重いかで決まる。
| 手 | 効く場面 | 効かない場面 |
|---|---|---|
| リードレプリカを足す | 読み取りの件数そのものが多い | 同じクエリの繰り返し(キャッシュの方が効く) |
| キャッシュを置く | 同じ結果を何度も返している | 毎回違うデータを引く |
| インデックスを足す/設計を直す | 検索条件に合うインデックスが無い | すでに最適なとき |
試験では
書き込みが重いときにリードレプリカを足しても解決しない。書き込みは主系に集まる。その場合はインスタンスを大きくする(垂直)、書き込みを分ける(シャーディング)、あるいは DynamoDB のような水平に伸びるものへ移す。
| 問題文に出る語 | 答えの方向 |
|---|---|
| 既存の MySQL / PostgreSQL をそのまま | Amazon RDS |
| 高い性能と可用性・ストレージが自動で伸びる | Amazon Aurora |
| 複数リージョンで読む・リージョン障害に備える | Aurora グローバルデータベース |
| 一桁ミリ秒・キーで引く・サーバーレス | Amazon DynamoDB |
| マイクロ秒まで速く(DynamoDB) | DAX |
| セッション・ランキング・Pub/Sub | ElastiCache for Redis |
| 単純なキャッシュを安く | ElastiCache for Memcached |
| MongoDB からの移行 | Amazon DocumentDB |
| 関係をたどる・推薦 | Amazon Neptune |
| 改ざんできない履歴 | Amazon QLDB |
| 接続数が尽きる(Lambda から) | Amazon RDS Proxy |
| 読み取りが重い | リードレプリカ/キャッシュ |
| 書き込みが重い | インスタンスを大きく/シャーディング/DynamoDB へ |
シナリオ演習
参照系のクエリが増えて RDS の CPU が上がっている。同じ内容のクエリが繰り返し実行されていることが分かった。費用も抑えたい。
補足
答え:ElastiCache を前に置いてクエリ結果をキャッシュする。
リードレプリカでも負荷は下がるが、台数ぶんインスタンス料金がかかる。「同じ内容が繰り返し」という語がキャッシュを指している。
シナリオ演習
Lambda から RDS へ接続している。アクセスが増えると「接続数が上限に達した」というエラーが出る。
補足
答え:RDS Proxy を挟んで接続をまとめて使い回す。
Lambda は同時実行数ぶん別々の実行環境が立ち上がり、それぞれが接続する。インスタンスを大きくして接続数上限を上げる案もあるが、費用対効果で劣る。
この章のまとめ
- キーで引くことに特化したサービス
- DynamoDB で結合はできるか
- Aurora が持つ複製の数と AZ
- Aurora のストレージの上限
- Aurora グローバルデータベースの複製の遅れ
- 偏ったパーティションキーで起きること
この章の根拠
最終確認 2026-10-04 / 対応バージョン DEA 2026-05-04 改訂版