第 10 章 高パフォーマンスなアーキテクチャの設計(24%)
データの取り込みと変換
この章で学ぶこと
- 適切なユースケースを伴うデータ分析と可視化のサービス(Athena、Lake Formation、QuickSight)
- データ取り込みのパターン(頻度)
- 適切なユースケースを伴うデータ転送サービス(DataSync、Storage Gateway)
- 適切なユースケースを伴うデータ変換サービス(AWS Glue)
- 取り込みのアクセスポイントのセキュリティ
この章に出てくる用語
- AWS Glue
- サーバーレスの ETL(抽出・変換・ロード)サービス。 クラスターを立てずに変換のジョブを動かせる。もう 1 つ重要なのが Glue データカタログで、「どこにどんな形のデータがあるか」のメタデータを持つ。クローラーが S3 を走査してスキーマを推定し、カタログに登録する。Athena も Redshift Spectrum も、このカタログを見てデータを読む。
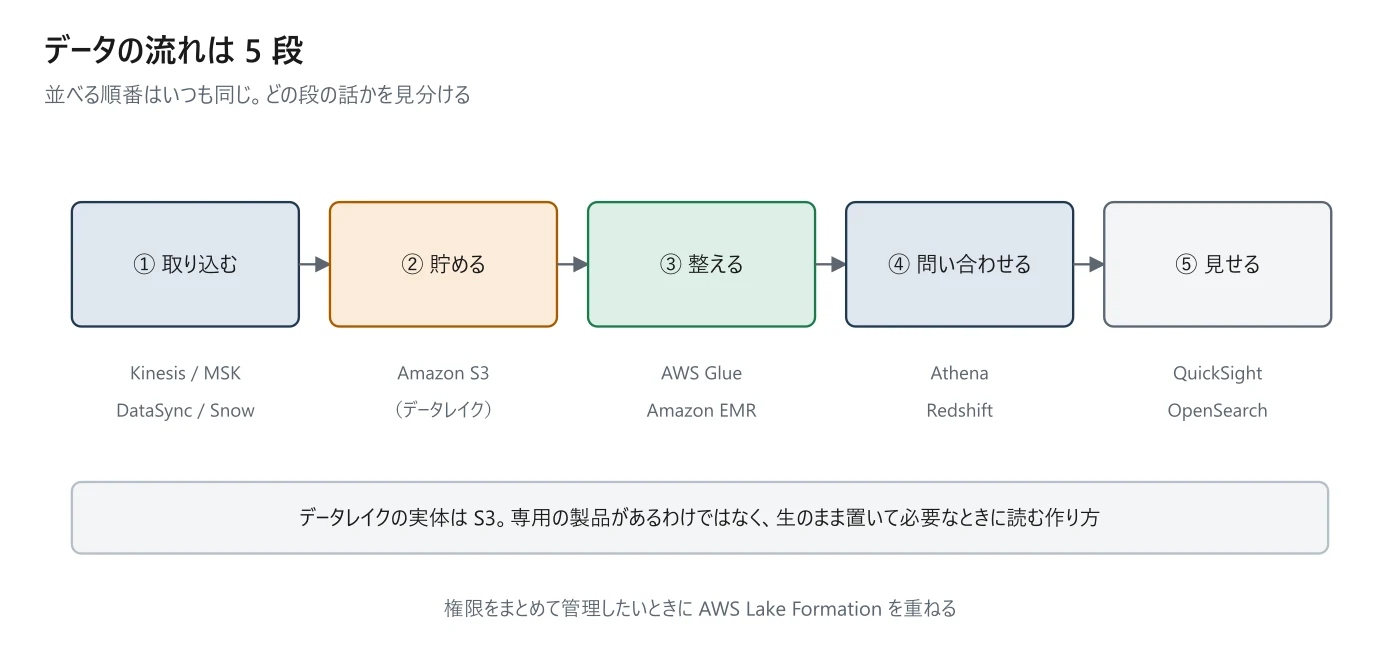
| 段 | やること | 代表的なサービス |
|---|---|---|
| ① 取り込む | 外からデータを受ける | Kinesis/MSK/DataSync/Snow/Transfer Family/DMS |
| ② 貯める | そのまま置く(データレイク) | Amazon S3 |
| ③ 整える | 形を揃える・結合する・変換する | AWS Glue/Amazon EMR |
| ④ 問い合わせる | SQL で聞く | Amazon Athena/Amazon Redshift |
| ⑤ 見せる | グラフや検索で見せる | Amazon QuickSight/Amazon OpenSearch Service |
補足
データレイクの実体は S3 だ。 専用の製品があるわけではなく、「生のデータをそのまま S3 に置き、必要なときに読む」という作り方を指す。権限をまとめて管理したいときに AWS Lake Formation を重ねる。
ストリーミングは「来たそばから処理する」形だ。Kinesis には用途の違う 2 つがあり、ここの区別が頻出する。
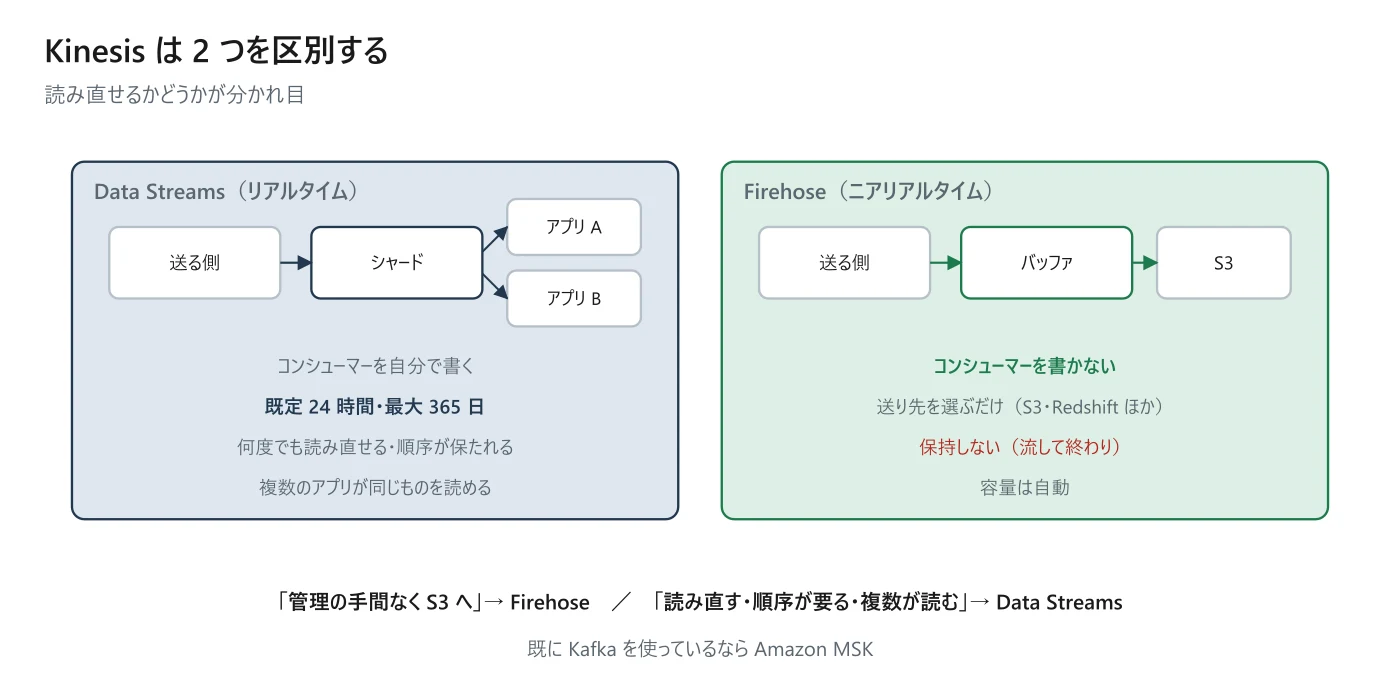
| Kinesis Data Streams | Kinesis Data Firehose | |
|---|---|---|
| 性格 | リアルタイム(ミリ秒〜秒) | ニアリアルタイム(バッファして送る) |
| 処理の書き方 | 自分でコンシューマーを書く | 書かない。 送り先を選ぶだけ |
| 送り先 | 任意(Lambda・Flink・アプリ) | S3・Redshift・OpenSearch・Splunk など |
| 保持 | 既定 24 時間(最大 365 日)何度でも読み直せる | 保持しない(流して終わり) |
| 容量 | シャードで決める(オンデマンドもあり) | 自動 |
| 向く場面 | 複数のアプリが同じストリームを読む・順序が要る | とにかく S3 へ流し込みたい |
試験では
「管理の手間なく S3 へ流し込みたい」は Firehose。「複数のアプリが同じデータを読む」「読み直したい」「順序が要る」は Data Streams。Firehose は読み直せないので、再処理が要る設問では落ちる。
- Amazon MSK ―― Apache Kafka をマネージドで動かす。既に Kafka を使っている・Kafka の API が要るときに選ぶ。
- Managed Service for Apache Flink ―― ストリームに対して SQL やコードで集計する。(旧 Kinesis Data Analytics)
- Kinesis Video Streams ―― 映像を流す用途。
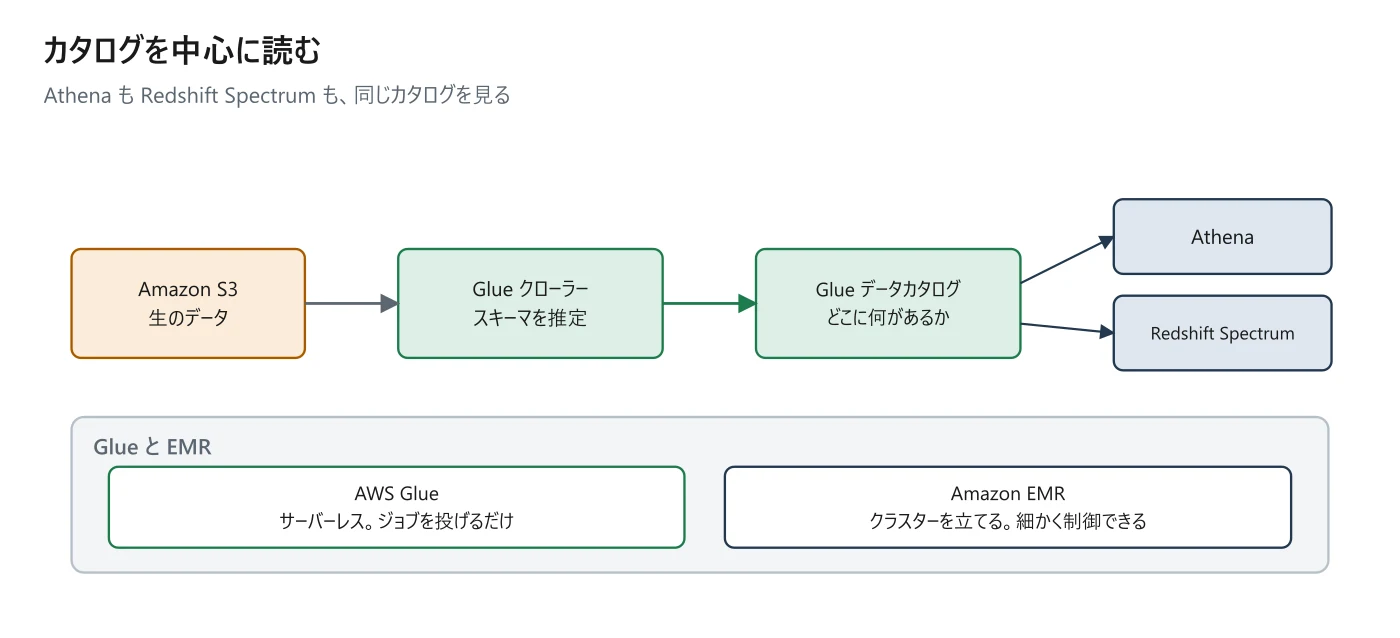
| AWS Glue | Amazon EMR | |
|---|---|---|
| 形 | サーバーレス。ジョブを投げるだけ | クラスターを立てる(Hadoop / Spark) |
| 運用 | ほぼ不要 | クラスターの設定と管理が要る |
| 細かい制御 | しにくい | できる(バージョン・ライブラリ・チューニング) |
| 向く場面 | ふつうの ETL・カタログ作り | 大規模・既存の Hadoop 資産・細かく詰めたい |
分析で問われる定番が CSV から Parquet への変換だ。公式の試験ガイドにも「.csv から .parquet へ」と明記されている。
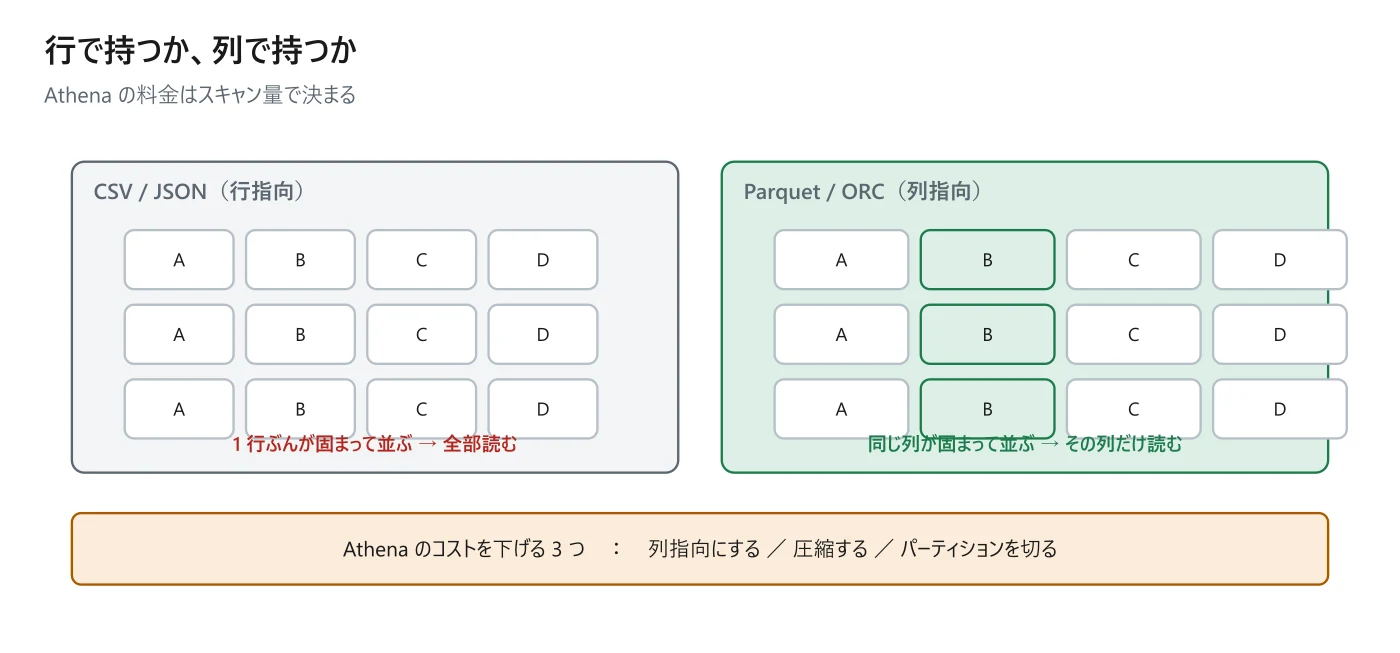
| CSV / JSON(行指向) | Parquet / ORC(列指向) | |
|---|---|---|
| 持ち方 | 1 行ぶんが固まって並ぶ | 同じ列の値が固まって並ぶ |
| 一部の列だけ読むとき | 全部読む | その列だけ読む |
| 圧縮の効き | 弱い | 強い(同じ種類の値が並ぶため) |
| Athena の料金 | 高くなる(走査量が多い) | 安くなる |
試験では
Athena はスキャンしたデータ量で課金される。料金を下げる手は 3 つで、列指向にする(Parquet)・圧縮する・パーティションを切るだ。「Athena のコストを下げたい」はこの 3 つのどれかが答えになる。
| Amazon Athena | Amazon Redshift | |
|---|---|---|
| 形 | サーバーレス。S3 に直接 SQL | クラスター(またはサーバーレス)にロードして使う |
| 準備 | 不要(カタログがあればすぐ) | ロードと設計が要る |
| 料金 | スキャンしたデータ量 | 動かしている時間/容量 |
| 向く場面 | たまに・アドホックに調べる | 繰り返し・大量・複雑な集計(BI の裏側) |
補足
Redshift Spectrum を使うと、Redshift から S3 のデータを直接読める。「よく使うデータは Redshift に、古いデータは S3 に置いたまま」という構成にできる(第 13 章のコストの話にも繋がる)。
試験では
「準備なしで S3 のログをたまに調べたい」は Athena。「毎日大量に集計して BI に出す」は Redshift。Athena に大量の定期集計をやらせると、スキャン量で高くつく。
| サービス | 向く場面 |
|---|---|
| Amazon QuickSight | ダッシュボード・BI。SPICE に取り込むと速い |
| Amazon OpenSearch Service | 全文検索・ログの検索と可視化(旧 Elasticsearch) |
| Amazon Managed Grafana | 時系列の監視ダッシュボード |
最後に、データを AWS へ持ってくる方法だ。一度だけか継続か、オンラインで送れる量かで分かれる。
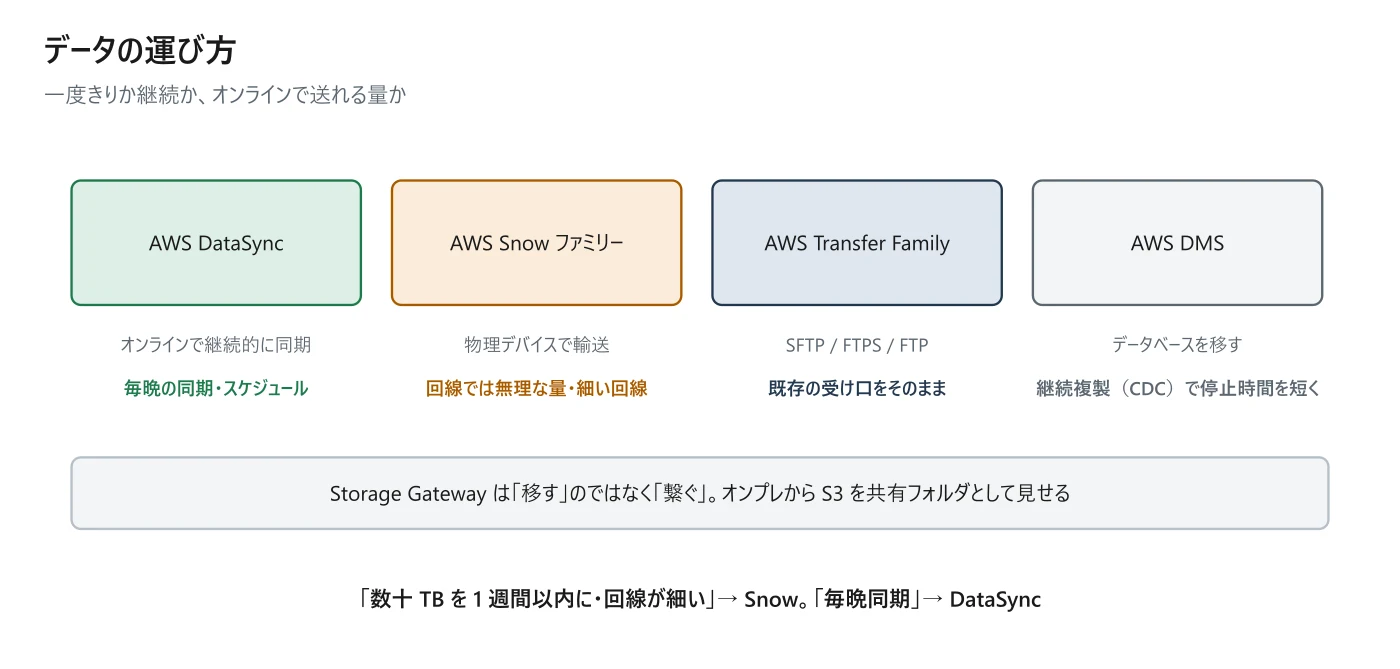
| やりたいこと | 使うもの | 押さえること |
|---|---|---|
| オンプレのファイルを継続的に同期 | AWS DataSync | スケジュールして自動で。暗号化と検証つき |
| 回線では無理な量を一度に運ぶ | AWS Snow ファミリー | 物理デバイスで輸送する |
| 既存の SFTP の受け口をそのまま | AWS Transfer Family | SFTP / FTPS / FTP で S3・EFS へ |
| データベースを移す・継続同期 | AWS DMS | 同種も異種も。異種は SCT でスキーマを変換 |
| オンプレのファイル共有を S3 に見せる | Storage Gateway | 移すのではなく繋ぐ(第 6 章) |
試験では
「数十 TB を 1 週間以内に」「回線が細い」は Snow ファミリー。オンラインで送ると何か月もかかる、という計算が設問に仕込まれていることがある。逆に「毎晩同期したい」は DataSync。一度きりか継続かで分ける。
データではなくサーバーごと AWS へ移す場合は、別の道具になる。順番は「調べる → 計画する → 移す」で、それぞれに担当がある。
| 段階 | サービス | 何をするか |
|---|---|---|
| 調べる | AWS Application Discovery Service | オンプレの構成と依存関係を集める |
| 計画・追跡 | AWS Migration Hub | 移行の進み具合を 1 か所で見る |
| 移す(サーバー) | AWS Application Migration Service | サーバーを丸ごと複製して切り替える |
| 移す(データベース) | AWS DMS(+ SCT) | 前節のとおり |
補足
DMS は停止時間を短くするために継続的な複製(CDC)ができる。全件コピーしたあと差分を流し続け、切り替えの直前まで追従させる。「ダウンタイムを最小にして移行したい」はこれが答え。
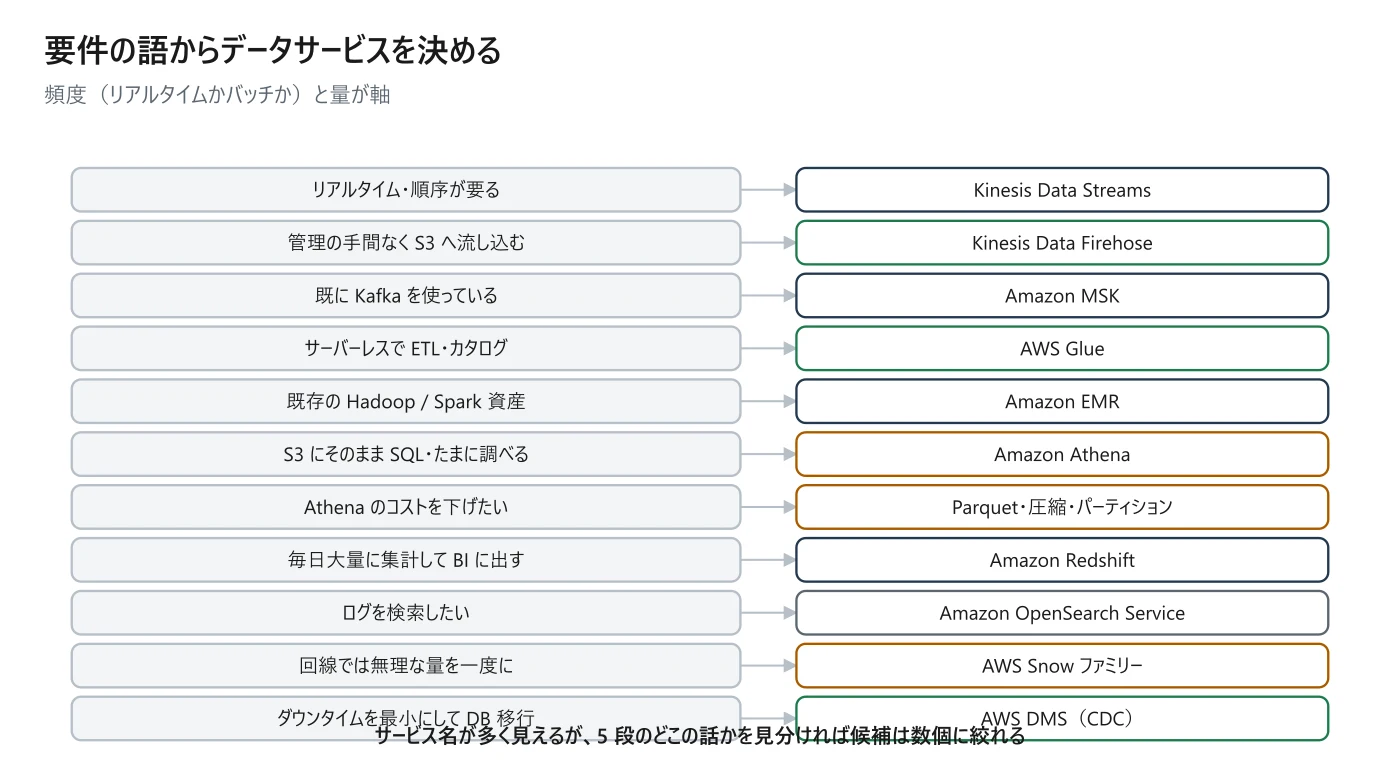
| 問題文に出る語 | 答えの方向 |
|---|---|
| リアルタイムに処理したい・順序が要る | Kinesis Data Streams |
| 管理の手間なく S3 へ流し込む | Kinesis Data Firehose |
| 既に Kafka を使っている | Amazon MSK |
| サーバーレスで ETL・カタログを作る | AWS Glue |
| 既存の Hadoop / Spark 資産 | Amazon EMR |
| S3 にそのまま SQL・たまに調べる | Amazon Athena |
| Athena のコストを下げたい | Parquet にする・圧縮・パーティション |
| 毎日大量に集計して BI に出す | Amazon Redshift |
| ダッシュボードを作る | Amazon QuickSight |
| ログを検索したい | Amazon OpenSearch Service |
| 毎晩オンプレから同期 | AWS DataSync |
| 回線では無理な量を一度に | AWS Snow ファミリー |
| ダウンタイムを最小にして DB を移す | AWS DMS(CDC) |
シナリオ演習
製造ラインの装置から 1 秒ごとに送られる計測値を、複数の分析アプリがそれぞれ別のタイミングで読みたい。再処理も必要になる。
補足
答え:Kinesis Data Streams に取り込み、各アプリが独立して読む。
Firehose は送り先へ流して終わりなので、読み直しも複数アプリでの消費もできない。「再処理」「複数のアプリ」という語が Data Streams を指している。
シナリオ演習
S3 に貯めた CSV のログに Athena でクエリしているが、料金が高い。クエリは日付で絞り、10 列のうち 2 列しか使っていない。
補足
答え:Parquet に変換し、日付でパーティションを切る。
Athena はスキャンしたデータ量で課金される。列指向にすれば使う 2 列だけを読み、パーティションを切れば対象日だけを読む。クエリの書き方を変えるだけでは、スキャン量は減らない。
この章のまとめ
- データレイクの実体
- データレイクの権限をまとめて管理するサービス
- リアルタイムで読み直しもできるストリーミング
- Data Streams の既定の保持期間と最大
- コンシューマーを書かずに S3 へ流し込むもの
- Kafka をマネージドで動かすサービス
この章の根拠
最終確認 2026-10-04 / 対応バージョン DEA 2026-05-04 改訂版